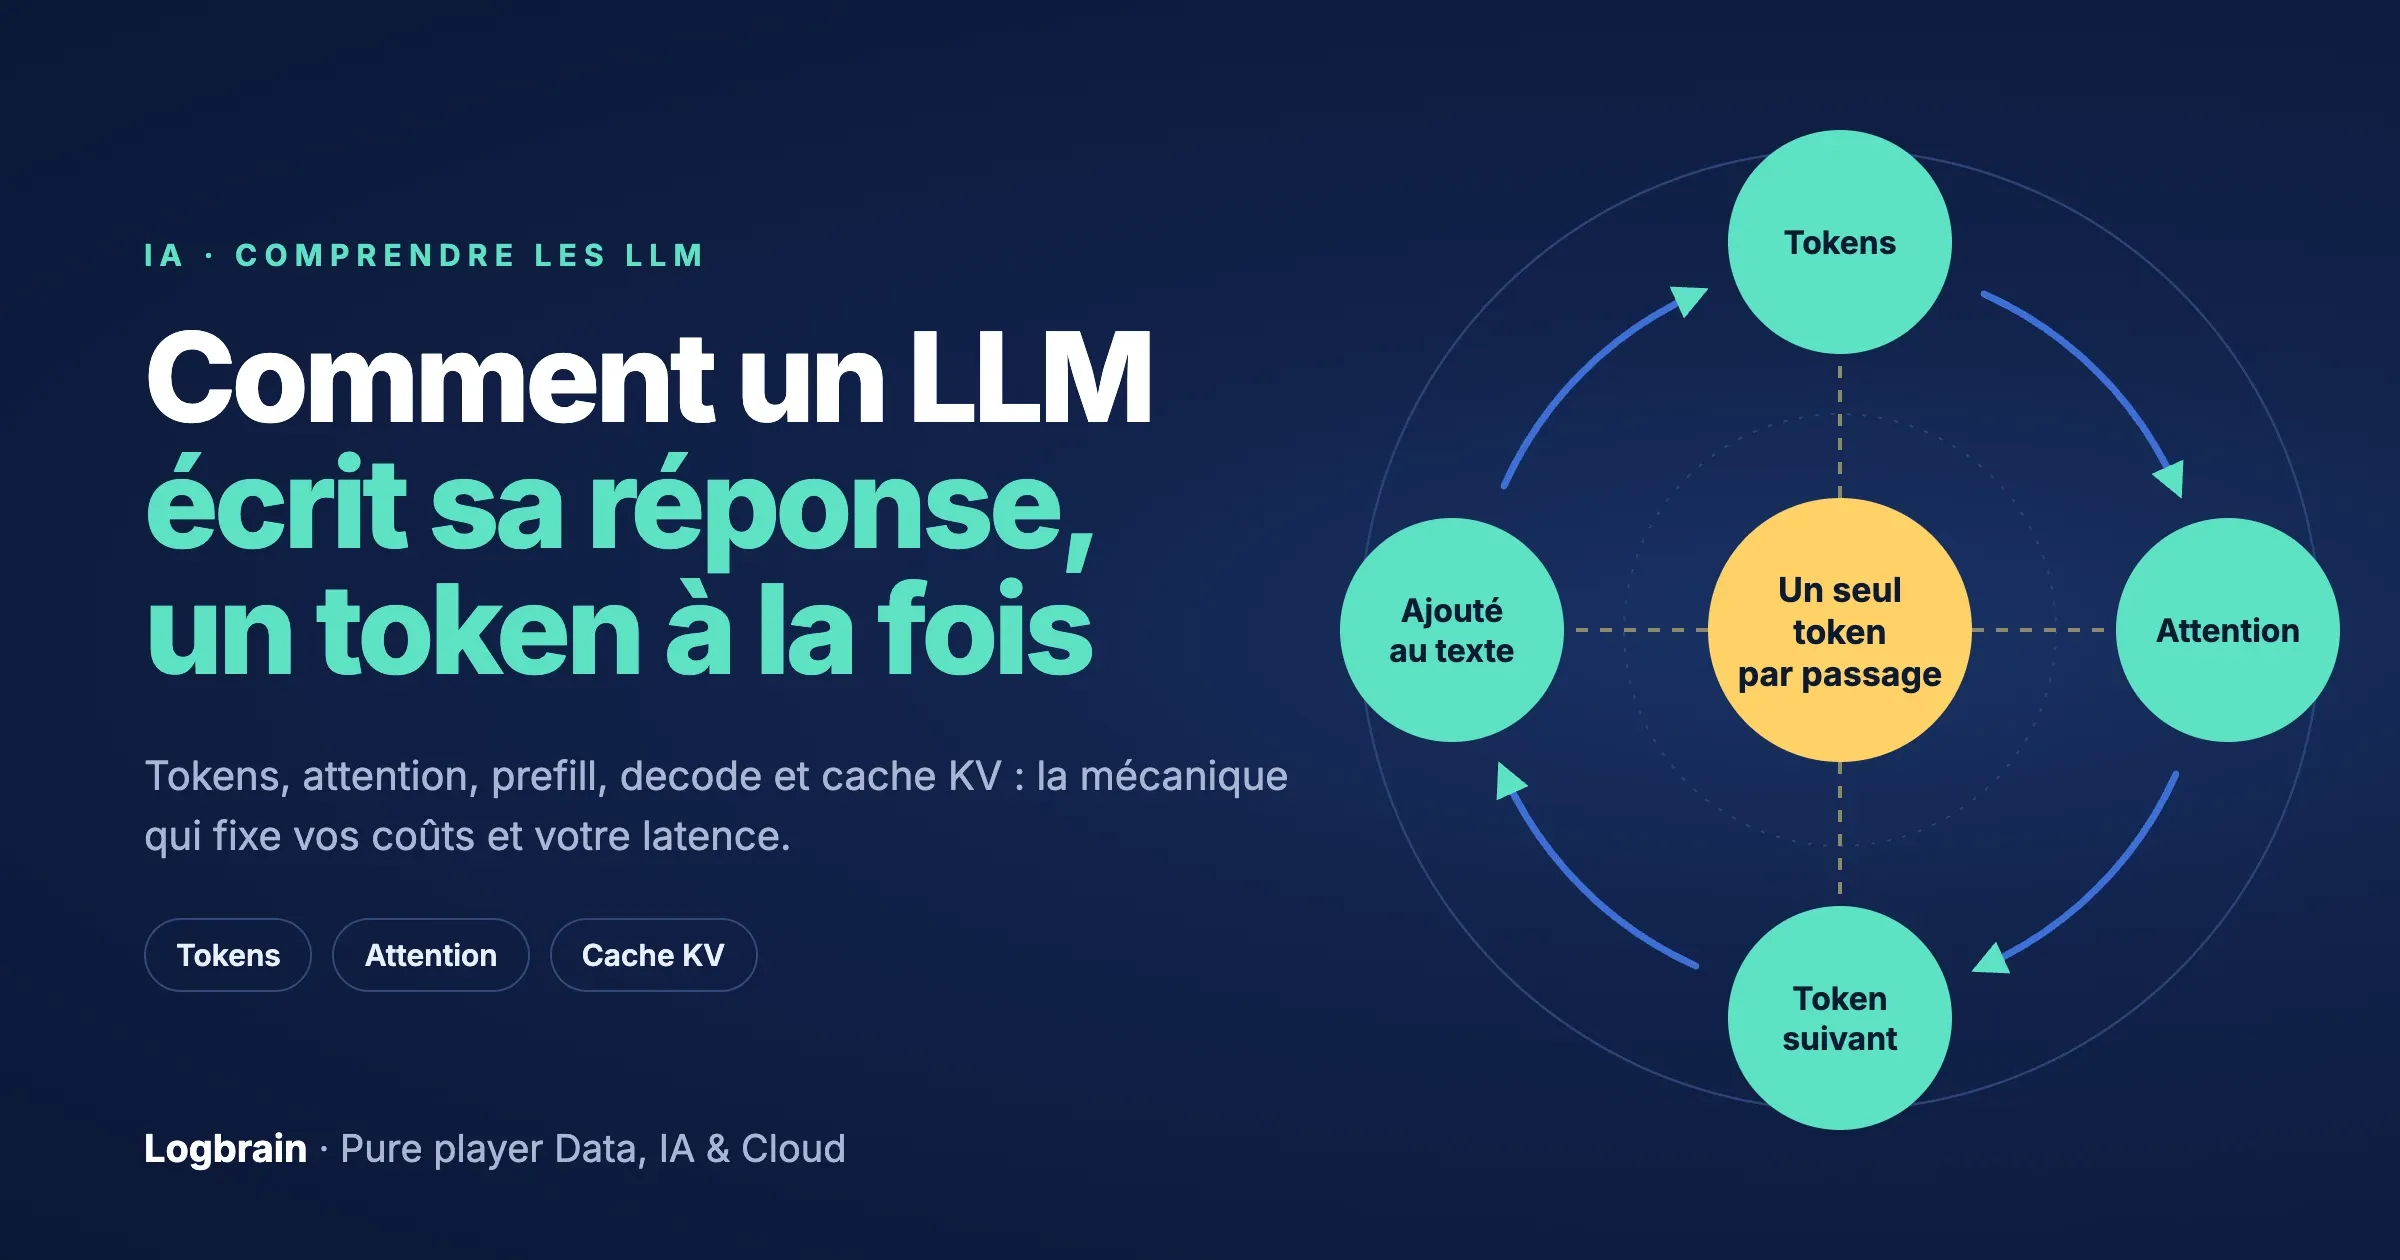
Vous tapez : « Résume ce contrat en trois points ». Vous appuyez sur Entrée. Une demi-seconde de silence. Puis les mots arrivent, en flot continu.
Pendant ce silence, votre phrase a été découpée en tokens, des petits morceaux de mots, puis transformée en nombres. Ces nombres ont traversé des dizaines de couches d’un réseau de neurones, le transformer. Tout ça pour produire… un seul token.
Et ce token n’est pas choisi d’avance. Le modèle calcule une probabilité pour chaque suite possible, puis tire au sort parmi les plus probables. Il est non déterministe : la même question peut donner deux réponses différentes.
Puis il recommence. Le nouveau token est ajouté au texte, et le modèle prédit le suivant, token après token, jusqu’au point final. C’est la génération autorégressive.
Cette mécanique explique ce que vous constatez en entreprise :
- un prix compté en tokens ;
- un temps d’attente avant le premier mot ;
- des réponses qui changent d’un essai à l’autre ;
- un ordre du prompt qui peut changer la facture.
Suivons cette phrase, étape par étape.
Le principe : deviner la suite
Un LLM (Large Language Model) ne fait qu’une chose : à partir d’un texte, il devine le morceau de texte suivant. Pas de réponses toutes prêtes, pas d’encyclopédie consultée.
C’est l’autocomplétion de votre téléphone, en démesuré. Pour bien deviner la suite de n’importe quel texte, le modèle a dû apprendre la grammaire, des faits, des raisonnements et du code.
Concrètement, un modèle, c’est deux choses :
- une architecture, la formule de calcul. Presque tous les LLM utilisent la même : le transformer ;
- des poids (ou paramètres), des milliards de nombres réglés pendant l’entraînement. Tout le « savoir » du modèle est là.
D’un modèle à l’autre, l’architecture change peu. Ce sont surtout les poids qui font la différence, donc les données d’entraînement.
Au fond, un LLM est une gigantesque fonction mathématique. Il prend en entrée une suite de nombres, et produit un nombre en sortie.
À l’intérieur, il y a un immense graphe d’opérations : des milliards de calculs, agencés avec soin, qui transforment les nombres d’entrée en ce nombre de sortie.
Ce graphe se découpe, en gros, en quatre parties.
Le texte traverse ces quatre parties pour produire un seul token. Ce token est ajouté au texte, et on recommence, jusqu’à un token spécial qui signifie « fin ». Prenons chaque partie dans l’ordre.
Étape 1 : les tokens
Avant de faire quoi que ce soit, le modèle doit transformer votre texte en ce qu’il sait manipuler : des nombres. C’est le rôle du tokenizer.
Il découpe le prompt en petits morceaux, et donne à chaque morceau un numéro : son token. Voici notre phrase passée dans le tokenizer d’OpenAI, celui de GPT-4o et GPT-5 :
6 mots deviennent 7 tokens.
La phrase devient la liste ["Rés", "ume", " ce", " contrat", " en", " trois", " points"], puis les nombres [109747, 3095, 2357, 33314, 469, 25564, 5571]. Pour le modèle, votre question n’est plus que ça.
Trois détails qui comptent :
- la même phrase donne toujours les mêmes tokens ;
- l’espace fait partie du token : « ␣contrat » est un seul morceau ;
- les majuscules comptent : « contrat » au milieu d’une phrase est un token (33314), mais « Contrat » en début de phrase devient « Contr » + « at ». Une majuscule dit quelque chose du mot : « Pierre » est sans doute un prénom, « pierre » un caillou.
Les tokens sont l’unité de base, à l’entrée comme à la sortie. Posons une question au modèle pour le voir en action. Appuyez sur ↑ quand vous êtes prêt :
Des numéros entrent, le calcul a lieu, un numéro sort. Le tokenizer le retraduit en texte, et il s’affiche. C’est pour ça que la réponse arrive token par token, par petits bouts.
Remarquez aussi que chaque token produit est ajouté à l’entrée avant le tour suivant. Le modèle a besoin de tout : sans la question, il oublierait ce qu’on lui demande ; sans le début de sa réponse, il recommencerait sans cesse le premier mot.
Il existe aussi des tokens spéciaux. L’un d’eux veut dire « fin de la réponse » : chez OpenAI, c’est le numéro 199999, celui qui termine la réponse ci-dessus. Quand le modèle le produit, il s’arrête. D’autres marquent le début et la fin de chaque message : c’est ainsi qu’un modèle de chat sait où finit votre question et où commence sa réponse.
Ce que ça change concrètement :
- vous payez en tokens, ceux que vous envoyez et ceux que le modèle écrit ;
- chaque fournisseur a son tokenizer : le même texte n’a pas le même coût partout. Vous pouvez comparer sur tiktokenizer ;
- le français et le code coûtent plus que l’anglais, car ils sont découpés plus finement ;
- compter les lettres d’un mot est difficile pour un modèle qui ne voit que des morceaux.
import tiktoken

tok = tiktoken.get_encoding("o200k_base")
ids = tok.encode("Résume ce contrat en trois points")
print([tok.decode([i]) for i in ids])  # les morceaux
Étape 2 : les embeddings
Le tokenizer nous a laissé des numéros. Problème : ces numéros ne veulent rien dire. « contrat » porte le numéro 33314, mais 33315 n’a aucun rapport avec lui. On ne calcule rien de sensé avec une étiquette.
Le modèle remplace donc chaque numéro par un embedding : une longue liste de nombres, appelée vecteur, qui décrit le sens du token.
Une immense table de consultation
Le modèle contient une table géante, avec une ligne par token du vocabulaire. Le token 33314 va chercher la ligne 33314. Pas de calcul : une simple consultation.
Chaque ligne compte des milliers de nombres : 7 168 pour DeepSeek-V3, par exemple. Avec un vocabulaire de 129 000 tokens, sa table pèse à elle seule près d’un milliard de paramètres.
Personne n’écrit ces nombres. Au départ, ils sont tirés au hasard. C’est l’entraînement qui les ajuste, petit à petit, jusqu’à ce qu’ils aident à bien deviner la suite.
Le sens devient de la géométrie
Un vecteur, c’est un point dans un espace à des milliers de dimensions. Et l’entraînement range ces points d’une façon remarquable : les mots de sens proche finissent voisins.
Chaque mot devient un point. Les mots de sens proche se retrouvent voisins.
Les directions ont même un sens. Aller de « France » à « Paris » ressemble à aller d’« Italie » à « Rome ». Dans les premiers modèles d’embeddings (word2vec, 2013), le calcul « roi − homme + femme » tombait tout près de « reine ». Personne ne l’a programmé : c’est apparu à l’entraînement.
Aucune dimension ne s’appelle « genre » ou « pays ». Le sens est réparti sur toutes à la fois, d’une manière que les chercheurs commencent à peine à décoder.
Combien de dimensions ?
Sur le schéma, on n’en montre que deux, pour pouvoir dessiner les mots sur une feuille. Un vrai modèle en utilise des milliers. Pourquoi autant ?
Parce qu’un mot a beaucoup de facettes. Avec deux dimensions, « avocat » doit choisir : près des fruits ou près des juristes. Avec des milliers, il peut être proche des deux à la fois, sur des axes différents. Chaque dimension en plus, c’est de la place pour une nuance de plus.
Ce nombre s’appelle la dimension du modèle, sa « largeur ». Chaque token garde un vecteur de cette taille d’un bout à l’autre, à travers toutes les couches. Quelques modèles récents :
- gpt-oss-120b (OpenAI, 2025) : 2 880 ;
- Qwen3 8B (Alibaba, 2025) : 4 096 ;
- Llama 4 Maverick (Meta, 2025) : 5 120 ;
- DeepSeek-V3 et Kimi K2 : 7 168.
Les modèles fermés (GPT-5, Claude, Gemini) ne publient pas ce chiffre.
Remarquez que la largeur ne suit plus la taille : gpt-oss-120b compte 120 milliards de paramètres, pour des vecteurs de 2 880 nombres seulement. Les modèles récents grossissent surtout en ajoutant des experts (l’architecture Mixture of Experts), pas en élargissant les vecteurs.
Plus de dimensions, c’est plus de nuances, mais aussi plus de calculs et de mémoire pour chaque token traité.
Un seul vecteur par mot, quel que soit le contexte
À ce stade, chaque token a un seul vecteur, toujours le même. « avocat » a le même embedding dans « un avocat bien mûr » et dans « l’avocat de la défense » : un point quelque part entre le fruit et le juriste.
Ce sont les couches suivantes qui le tireront d’un côté ou de l’autre, en regardant les mots autour. C’est l’étape 3. Mais avant, il manque une information essentielle.
L’ordre des mots : les embeddings de position
L’embedding de « Jean » est le même, où qu’il soit dans la phrase. Sans autre information, « Jean mange la pomme » et « La pomme mange Jean » donnent exactement les mêmes vecteurs : pour le transformer, c’est la même chose.
Il faut donc lui donner la position de chaque token. Trois méthodes se sont succédé :
- la formule fixe, dite sinusoïdale (le transformer d’origine, 2017) : la position est calculée avec des sinus et des cosinus, puis ajoutée à l’embedding. Rien à apprendre ;
- la position apprise (GPT-2, BERT) : une table avec un vecteur par position, réglée pendant l’entraînement comme le reste. Plus souple, mais limitée : GPT-2 a appris 1 024 positions, BERT 512. Au-delà, il n’existe tout simplement pas de vecteur pour la position suivante ;
- RoPE (Rotary Position Embedding), le standard actuel (Llama, Mistral, Qwen…) : une formule fixe, mais plus maligne. Au lieu d’ajouter la position à l’embedding, elle fait tourner les vecteurs d’un angle qui dépend de la position, au moment où les mots se comparent dans l’attention.
Avec RoPE, ce qui compte est la distance entre deux mots, pas leur place absolue. « Jean » deux mots avant « mange » donne la même relation, que la phrase soit au début du texte ou au 50 000e token. C’est l’une des clés qui ont permis, avec quelques ajustements, d’étendre les fenêtres de contexte à des centaines de milliers de tokens.
Étape 3 : le transformer
C’est le cœur du modèle, et là que se fait presque tout le calcul. Le transformer est une pile de blocs identiques, qu’on appelle des couches : 36 pour Qwen3 8B ou gpt-oss-120b, 61 pour DeepSeek-V3.
Chaque couche contient deux étages :
- l’attention : chaque mot regarde les autres et y puise de l’information ;
- le feedforward : chaque mot, seul, « réfléchit » à ce qu’il vient d’apprendre.
Une couche ne remplace pas le vecteur d’un mot : elle lui ajoute une correction. Au fil des couches, le vecteur de « avocat » glisse vers le fruit ou vers le juriste, selon la phrase. On parle de flux résiduel : un courant qui traverse toute la pile et s’enrichit à chaque étage.
L’attention : chaque mot regarde les autres
Prenons notre réponse en cours : « Le contrat dure ». Pour deviner la suite, « dure » a besoin de savoir ce qui dure. Il va donc regarder surtout « contrat ».
« contrat » regarde surtout « Le ». Les mots qui suivent lui sont invisibles.
Touchez un mot
Comment un mot sait-il qui regarder ? Chaque couche a appris trois matrices. En y multipliant le vecteur de chaque mot, on obtient trois nouveaux vecteurs :
- une requête (query, Q) : ce que je cherche ;
- une clé (key, K) : ce que je propose ;
- une valeur (value, V) : ce que je transmets si on me choisit.
Comme dans une réunion : chacun a une question en tête, lit les badges des autres, et écoute surtout ceux qui peuvent l’aider.
Le calcul, pas à pas
Faisons-le à la main, sur quatre tokens. Pour rester lisible, chaque vecteur n’a ici que deux nombres. En vrai, il en a une centaine par tête.
Chaque case vaut Q · K : la requête du mot de la ligne, multipliée par la clé du mot de la colonne. Pour « dure » et « contrat » : (1 ; 1) · (1 ; 2) = 1×1 + 1×2 = 3.
Touchez un mot ou une ligne pour suivre son calcul
- Comparer. On multiplie la requête de chaque mot par la clé de chaque autre : c’est le produit scalaire. Pour « dure » et « contrat » : (1 ; 1) · (1 ; 2) = 1×1 + 1×2 = 3. Plus deux vecteurs pointent dans la même direction, plus le score est haut.
- Masquer. Au-dessus de la diagonale, c’est le futur : « dure » ne peut pas regarder « trois », qui n’est pas encore écrit. On y met −∞.
- Normaliser. Le softmax transforme chaque ligne en poids qui font 100 % : on prend l’exponentielle de chaque score, puis on divise par le total. Pour « dure » : e¹ = 2,7, e³ = 20,1 et e² = 7,4, soit 9 %, 67 % et 24 %. L’exponentielle de −∞ vaut 0 : le futur pèse exactement 0 %.
- Mélanger. Le nouveau vecteur de « dure » est la somme des valeurs, pondérée par ces poids : 9 % de « Le », 67 % de « contrat », 24 % de lui-même. Il porte maintenant surtout l’information de « contrat ».
Deux différences avec la réalité. On divise aussi les scores par la racine carrée de la taille des vecteurs, pour éviter qu’ils deviennent trop grands. Et la grille ne fait pas 4 × 4 : avec 100 000 tokens de contexte, elle compte 10 milliards de cases, pour chaque tête de chaque couche. C’est pour ça que les longs contextes coûtent si cher.
Tous ces calculs sont des multiplications de matrices. C’est exactement ce que les GPU savent faire en masse, et en parallèle.
import numpy as np

def attention(Q, K, V):
    scores = Q @ K.T / np.sqrt(K.shape[-1])           # 1. comparer
    futur = np.triu(np.ones_like(scores), k=1) == 1
    scores[futur] = -np.inf                           # masque : pas de futur
    poids = np.exp(scores)
    poids /= poids.sum(-1, keepdims=True)             # 2. softmax
    return poids @ V                                  # 3. mélanger
Trois sortes d’attention
Selon qui a le droit de regarder qui, on distingue trois attentions.
Self-attention
Chaque mot regarde tous les autres, avant et après.
Encodeurs : BERT, modèles d’embedding
Self-attention masquée
Chaque mot ne regarde que ceux d’avant.
Décodeurs : GPT, Claude, Llama, Qwen
Cross-attention
Le texte écrit regarde un autre texte.
Encodeur-décodeur : traduction, Whisper
- La self-attention (auto-attention) : chaque mot regarde tous les mots du même texte, avant et après. Idéal pour comprendre une phrase entière d’un coup.
- La self-attention masquée (ou causale) : chaque mot ne regarde que les mots précédents. Un masque cache le futur. C’est indispensable pour générer : quand le modèle écrit le troisième mot, le quatrième n’existe pas encore.
- La cross-attention (attention croisée) : les requêtes viennent d’un texte, les clés et les valeurs d’un autre. Le texte en cours d’écriture interroge un texte déjà lu.
Le masque a deux bonus. À l’entraînement, il permet d’apprendre toutes les positions d’une phrase en un seul passage. Et à l’inférence, il garantit que le calcul d’un mot ne change jamais une fois fait : c’est ce qui rendra le cache KV possible.
Encodeur, décodeur : trois familles de modèles
Le transformer d’origine (Google, 2017) servait à traduire. Il avait deux parties :
- un encodeur, qui lit la phrase source avec de la self-attention ;
- un décodeur, qui écrit la traduction avec de la self-attention masquée, et qui consulte l’encodeur par cross-attention.
Depuis, chaque moitié a fait sa vie :
- encodeur seul (BERT, ModernBERT) : comprendre, classer, produire des embeddings pour la recherche. Il ne génère pas de texte ;
- encodeur-décodeur (T5, Whisper) : transformer un texte en un autre, ou un son en texte ;
- décodeur seul (GPT, Claude, Llama, Qwen, DeepSeek) : générer, token après token.
C’est le décodeur seul qui a gagné pour les LLM. Il est plus simple, une seule pile, et il ramène toute tâche à une seule : continuer un texte. Traduire, résumer ou répondre deviennent des cas particuliers. Et il s’entraîne sur n’importe quel texte, sans paires question-réponse.
Plusieurs têtes en parallèle
Une seule attention ne peut suivre qu’un type de relation à la fois. Chaque couche en fait donc tourner des dizaines en parallèle, les têtes : 64 pour gpt-oss-120b, 128 pour DeepSeek-V3.
Personne ne leur assigne de rôle. Mais en les observant, on trouve des têtes qui relient un verbe à son sujet, un pronom à son nom, ou une parenthèse ouvrante à sa fermante.
Les modèles récents font partager les mêmes clés et valeurs à plusieurs têtes : c’est le GQA (Grouped-Query Attention). Qwen3 8B a 32 têtes de requêtes pour seulement 8 de clés et de valeurs. La qualité baisse à peine, et la mémoire du cache KV est divisée par quatre.
Le feedforward : là où sont rangées les connaissances
Après l’attention, chaque vecteur passe seul dans le feedforward : un petit réseau qui l’agrandit (trois à quatre fois), le transforme, puis le ramène à sa taille.
Il n’a l’air de rien, mais il concentre environ deux tiers des paramètres. Les chercheurs y voient une sorte de mémoire : c’est là que le modèle range une bonne partie de ce qu’il sait, comme « Paris est en France ».
C’est aussi là qu’interviennent les experts. Dans un modèle Mixture of Experts, le feedforward est découpé en de nombreux petits réseaux, et un aiguilleur n’en active que quelques-uns pour chaque token. DeepSeek-V3 compte 671 milliards de paramètres, mais n’en utilise que 37 milliards par token. Le modèle sait beaucoup, mais calcule peu.
Au bout de la pile
Après la dernière couche, le vecteur du dernier token a tout absorbé : la question, le contexte, le début de la réponse. Il ne reste qu’à le transformer en mot. C’est l’étape 4.
Étape 4 : la sortie, choisir le token suivant
On sort de la pile avec un seul vecteur utile : celui du dernier token, qui a tout absorbé. Chez DeepSeek-V3, c’est une liste de 7 168 nombres. Il faut maintenant en tirer un mot.
Du vecteur aux scores : les logits
Le modèle a une seconde table, le miroir de celle des embeddings : une ligne par token du vocabulaire. Certains modèles réutilisent d’ailleurs la même.
Il compare le vecteur à chacune de ces lignes, avec le geste qu’on connaît déjà : le produit scalaire. Plus le vecteur ressemble à la ligne de « trois », plus « trois » obtient un score élevé.
On obtient un score pour chacun des 200 000 tokens du vocabulaire. Ces scores bruts s’appellent les logits. Après « Le contrat dure », par exemple :
- « trois » : 3 ;
- « deux » : 2,2 ;
- « cinq » : 1,6 ;
- « un » : 1,1 ;
- « pizza » : −1,5.
Des scores aux probabilités : le softmax, encore
Pour passer des scores aux probabilités, c’est le même softmax que dans l’attention : l’exponentielle de chaque score, divisée par le total.
Les exponentielles valent 20,1 pour « trois », 9,0 pour « deux », 5,0 pour « cinq », 3,0 pour « un » et 0,2 pour « pizza ». Sur un total de 37,3, cela donne 54 % pour « trois », 24 % pour « deux », 13 % pour « cinq », 8 % pour « un » et 0,6 % pour « pizza ».
Le modèle ne choisit pas « trois ». Il tire au sort selon ces probabilités : une fois sur deux environ, il écrira autre chose.
La température : accentuer ou aplatir
Avant le softmax, on divise tous les logits par un nombre : la température.
- Température 1 : on ne change rien. « trois » a 54 % de chances.
- Température 0,5 : les écarts doublent, le favori écrase les autres. « trois » monte à 78 %.
- Température 1,5 : les écarts se tassent, les outsiders reviennent. « trois » descend à 43 %, et « pizza » passe de 0,6 % à 2 %.
- Température 0 : plus de hasard, on prend toujours le premier. C’est le mode greedy.
Le contrat dure …
Couper la traîne : top-k, top-p, min-p
Notre exemple n’a que cinq candidats. Le vrai en a 200 000, dont des milliers d’absurdes à 0,001 %. Pris un par un, ils sont négligeables. Ensemble, ils finissent par sortir, surtout à température haute.
On coupe donc cette traîne avant le tirage :
- top-k : on garde les k meilleurs, par exemple les 40 premiers ;
- top-p : on garde les meilleurs jusqu’à atteindre p % de probabilité cumulée. Avec top-p à 90 %, « trois », « deux » et « cinq » suffisent (91 %) : « un » et « pizza » sont éliminés ;
- min-p : on garde ceux qui pèsent au moins une fraction du favori, par exemple 10 %. La coupe s’adapte toute seule : serrée quand le modèle est sûr de lui, large quand il hésite.
Les probabilités restantes sont ramenées à 100 %, puis on tire.
Pourquoi deux réponses différentes
C’est ce tirage qui rend le modèle non déterministe, comme annoncé au début. Même question, même modèle : un autre tirage au premier token, et toute la suite diverge.
Même à température 0, deux appels peuvent différer légèrement. Sur les serveurs, votre requête est calculée en lot avec celles d’autres utilisateurs, et l’ordre des additions change d’une fois à l’autre. Les arrondis bougent d’un cheveu, et parfois, cela suffit à changer le favori.
Certains modèles de raisonnement ne laissent d’ailleurs pas régler la température : le fournisseur l’impose.
Imposer un format : la sortie structurée
Quand vous demandez un JSON, le moteur peut faire mieux qu’espérer. Avant chaque tirage, il met à −∞ les logits de tous les tokens qui casseraient le format : un texte libre là où il faut une accolade, un nombre là où il faut un texte.
C’est exactement l’astuce du masque dans l’attention. L’exponentielle de −∞ vaut 0 : ces tokens ne peuvent plus sortir. Le JSON est valide par construction.
Et on recommence
Le token tiré est ajouté au texte, et tout repart dans le modèle : c’est la boucle qu’on a vue avec la fenêtre de chat de l’étape 1. Elle s’arrête au token de fin, ou quand la limite de longueur fixée par l’appel (max_tokens) est atteinte.
Prefill et decode : les deux temps de la génération
On sait maintenant ce qui se passe dans le modèle. Regardons la même chose du côté de la machine, car c’est là que se jouent votre facture et votre temps d’attente.
Un rappel d’abord : pendant l'inférence, le modèle n’apprend plus rien, ses poids sont figés. L’entraînement a lieu une fois. L’inférence, elle, tourne des milliards de fois, à chaque question de chaque utilisateur. C’est là que vit le coût.
Et l’inférence n’est pas une opération, mais deux, qui se comportent de façon opposée.
Entrée
Modèle
poids : 16 Go
Mémoire GPU · cache KV
0 tokens en cache
Un prompt de 6 tokens arrive.
Phase 1 : le prefill, tout le prompt d’un coup
Vous envoyez un prompt de 2 000 tokens. Le modèle les connaît tous dès le départ. Il peut donc les traiter en parallèle : à chaque couche, chaque token calcule sa requête, sa clé et sa valeur, et la grille d’attention de l’étape 3 est calculée en entier, d’un seul bloc.
Ce sont d’énormes multiplications de matrices. Les unités de calcul du GPU tournent à plein : on dit que le prefill est limité par le calcul (compute-bound).
Le prefill produit deux choses :
- le premier token de la réponse ;
- le cache KV : à chaque couche, les clés et les valeurs des 2 000 tokens, rangées dans la mémoire du GPU.
Les requêtes, elles, ne sont pas gardées. Une requête, c’est la question d’un token au moment où il est traité. Les clés et les valeurs, c’est le passé, que tous les tokens suivants viendront consulter. Elles restent.
Le prefill, c’est le silence du début : le temps avant le premier token, ou TTFT (Time To First Token).
Phase 2 : le decode, un token à la fois
Le premier token repart dans le modèle. Mais cette fois, il est seul.
Il calcule sa requête, sa clé et sa valeur. Sa clé et sa valeur s’ajoutent au cache. Sa requête interroge toutes les clés du cache : les 2 000 du prompt, plus celles de tous les tokens déjà écrits. Dans la grille d’attention, on ne calcule plus qu'une seule ligne, la dernière.
Il en sort un nouveau token, qui repart à son tour. C’est la boucle autorégressive : chaque token dépend du précédent, donc impossible de paralléliser.
Et voilà le problème. Pour ce seul token, le GPU doit relire tous les poids du modèle et tout le cache depuis sa mémoire. Très peu de calcul, énormément de lecture. Le decode est limité par la mémoire, ou plus exactement par sa bande passante (memory-bound).
Faisons le calcul. Un modèle de 8 milliards de paramètres pèse 16 Go en 16 bits. Un GPU H100 lit sa mémoire à environ 3 350 Go par seconde. Pour chaque token, il faut relire ces 16 Go : au mieux 200 tokens par seconde, même si les unités de calcul restent presque au repos.
D’où l’astuce des serveurs : le batching. Tant qu’à relire les poids, on s’en sert pour avancer d’un token les réponses de 32 ou 64 utilisateurs à la fois. Une seule lecture, des dizaines de tokens.
Le decode, c’est le flot : le temps entre deux tokens, ou TPOT (Time Per Output Token).
Deux phases, deux goulots
- Le prefill traite tout le prompt en parallèle. Il est limité par le calcul, et c’est lui qui fait le temps d’attente avant le premier mot. Il s’allonge avec la taille du prompt.
- Le decode traite un token à la fois. Il est limité par la lecture de la mémoire, et c’est lui qui fait la vitesse du flot. Il s’allonge avec la longueur de la réponse.
Même modèle, même requête, mais deux profils matériels opposés. C’est pour ça que l’optimisation de l’inférence est un métier à part, et que les gros déploiements vont jusqu’à faire tourner les deux phases sur des machines différentes.
Les quatre mesures à connaître
- TTFT : l’attente avant le premier token. Surtout le prefill, mais aussi la file d’attente et le réseau.
- TPOT : le temps entre deux tokens, une fois le flot lancé. Surtout le decode.
- Le débit (throughput) : le nombre total de tokens produits par seconde, tous utilisateurs confondus.
- La latence totale : de l’envoi à la fin de la réponse. En gros, TTFT + nombre de tokens × TPOT. Une réponse de 500 tokens à 30 ms par token, après 0,5 s d’attente : 15,5 secondes.
Les deux premières, c’est ce que ressent l’utilisateur. Le débit et le coût par token, c’est ce que ressent votre direction financière. Et les deux tirent en sens inverse : mettre plus d’utilisateurs dans le même lot augmente le débit, mais ralentit chacun d’eux. Optimiser l’inférence, c’est choisir le bon point sur cette courbe.
Ce que ça change pour vous
- Les tokens de sortie coûtent plus cher que ceux d’entrée, souvent 4 à 8 fois plus : ils passent un par un dans le decode ;
- un long document retarde le premier mot, mais ralentit peu la suite ;
- une longue réponse coûte du temps et de l’argent : demander « en trois points » est une optimisation ;
- le streaming est indispensable : afficher les tokens au fil de l’eau masque l’attente.
Le cache KV : ne jamais recalculer le passé
Le cache KV est né pendant le prefill. Voyons pourquoi il change tout, et ce qu’il coûte.
Le gaspillage qu’il évite
Sans cache, chaque nouveau token obligerait à refaire passer tout le texte dans le modèle : le prompt et tout ce qui a déjà été écrit.
Prenons un prompt de 2 000 tokens et une réponse de 500. Sans cache, le modèle traiterait 2 000 tokens pour le premier mot, 2 001 pour le deuxième, et ainsi de suite : plus d'un million de passages de tokens au total. Avec le cache : 2 000 au prefill, puis un par token écrit, soit 2 500. Plus de 400 fois moins de travail.
Sans cache
1 calcul
Avec le cache KV
1 calcul
Pour écrire « Le » : sans cache, on refait tout ; avec le cache, seulement le nouveau token.
Pourquoi c’est possible : le masque
Ce raccourci repose sur le masque causal de l’étape 3. Un token ne regarde jamais ceux qui le suivent. Donc quand « trois » arrive, les clés et les valeurs de « Le contrat dure » ne bougent pas d’un chiffre : rien de ce qui vient après ne peut les influencer.
Calculées une fois, elles restent justes pour toujours. On peut donc les garder.
Ce qu’il pèse vraiment
Le prix, c’est la mémoire du GPU. Pour chaque token, le cache garde une clé et une valeur, à chaque couche et pour chaque tête de clés. Pour Qwen3 8B :
Le calcul : 2 (clé et valeur) × 36 couches × 8 têtes × 128 nombres × 2 octets ≈ 147 Ko par token.
Ça paraît peu. Mais une conversation de 32 000 tokens pèse déjà 4,7 Go, et une de 128 000 tokens près de 19 Go. Plus que le modèle lui-même, qui fait 16 Go.
Un GPU H100 (80 Go) qui sert Qwen3 8B
Ça tient : 25 Go utilisés sur 80.
Chaque token garde 147 Ko de clés et de valeurs : 1,18 Go par conversation.
C’est là que le GQA de l’étape 3 prend tout son sens. Sans lui, avec 32 têtes de clés au lieu de 8, chaque token pèserait quatre fois plus lourd.
Sur un serveur chargé, c’est donc souvent le cache, et non le calcul, qui fixe le nombre d’utilisateurs qu’un GPU peut servir. D’où trois familles de parades :
- l’architecture : le GQA, ou des variantes plus poussées comme le MLA de DeepSeek, qui compresse les clés et les valeurs. Elle se choisit à l’entraînement : on prend un modèle qui l’a déjà ;
- la compression : stocker le cache en 8 bits au lieu de 16, pour deux fois moins de mémoire ;
- le rangement : PagedAttention, inventé par le moteur vLLM, découpe le cache en petits blocs, comme la mémoire d’un système d’exploitation. Plus de place réservée pour rien.
Le prompt caching : réutiliser le travail d’une requête à l’autre
Le cache KV sert pendant une réponse. Mais que se passe-t-il entre deux messages ?
Un modèle sans mémoire
Un LLM ne se souvient de rien d’une requête à l’autre : on dit qu’il est stateless. Pour simuler une conversation, l’application renvoie tout l’historique à chaque message : instructions, documents, échanges précédents, nouvelle question.
Sans précaution, chaque message refait donc tout le prefill, et coûte un peu plus que le précédent. Au vingtième échange, on paie vingt fois le même début de conversation.
Garder le cache entre deux requêtes
Le prompt caching (ou prefix caching) garde le cache KV d’une requête pour la suivante. Si votre nouvelle requête commence par exactement les mêmes tokens qu’une requête récente, le fournisseur saute le prefill de ce début commun, le préfixe, et le relit depuis la mémoire.
Requête 1
tout calculé
Requête 2
début relu depuis le cache
Requête 3
une date au début : tout recalculé
Le stable au début, le variable à la fin : le début identique n’est jamais recalculé.
Le gain est double :
- le prix : les tokens lus depuis le cache sont facturés de 10 à 50 % du prix normal selon les fournisseurs ;
- la latence : moins de prefill, donc un premier mot qui arrive beaucoup plus vite.
Chez OpenAI, c’est automatique dès 1 024 tokens de préfixe commun. Chez Anthropic, on marque explicitement les endroits à mettre en cache. Dans tous les cas, le cache expire après quelques minutes sans usage.
Pourquoi seul le début compte
Pourquoi faut-il un préfixe identique, et pas seulement des passages communs ?
Parce que dans les couches profondes, la clé et la valeur d’un token dépendent de tous les tokens qui le précèdent : c’est tout l’intérêt de l’attention. Changez un seul token au début, et les clés et valeurs de tout ce qui suit changent aussi. Le cache ne vaut plus rien à partir du premier token différent.
Une seule règle : l’ordre
- Au début, ce qui ne change jamais : instructions, définitions d’outils, documents de référence.
- Ensuite, ce qui grandit : l’historique de la conversation, toujours ajouté à la fin.
- À la fin, ce qui varie : la question de l’utilisateur, la date, les données du moment.
Les pièges classiques, tous vus en production :
- la date ou le nom de l’utilisateur en première ligne : le préfixe change à chaque requête ;
- des outils listés dans un ordre qui varie d’un appel à l’autre ;
- un JSON dont les clés changent d’ordre à la sérialisation ;
- un identifiant unique ou un horodatage glissé dans les instructions ;
- un historique résumé ou réécrit en cours de route, qui casse tout ce qui suit.
La fenêtre de contexte
La fenêtre de contexte, c’est le nombre maximal de tokens que le modèle peut prendre en compte d’un coup.
L’entrée et la sortie se partagent la place
Souvenez-vous de la boucle : chaque token écrit est ajouté à l’entrée. La fenêtre doit donc contenir les instructions, les documents, l’historique, la question et la réponse en cours d’écriture.
Avec une fenêtre de 200 000 tokens et un prompt de 180 000, il reste 20 000 tokens pour répondre. Les fournisseurs fixent en plus une limite de sortie séparée, bien plus petite que la fenêtre.
Ce qui fixe sa taille
Tout ce qu’on a vu jusqu’ici se retrouve ici :
- la position : le modèle doit savoir se repérer sur toute la longueur. C’est le rôle de RoPE, étendu par des ajustements ;
- l’entraînement : il faut lui avoir montré de très longs textes, souvent pendant le mid-training ;
- la mémoire : le cache KV grossit avec chaque token, comme le montre le calculateur plus haut ;
- le calcul : la grille d’attention grandit avec le carré de la longueur. Dix fois plus de texte, cent fois plus de cases.
Annoncée n’est pas utile
Les fenêtres sont devenues immenses : de 200 000 tokens à plusieurs millions selon les modèles. Mais plus long ne veut pas dire mieux :
- l’attention se dilue : un détail noyé au milieu d’un long contexte est moins bien exploité qu’au début ou à la fin. C’est l’effet lost in the middle ;
- le bruit nuit : des documents hors sujet dégradent la réponse ;
- le coût et la latence montent avec chaque token, surtout au prefill.
En pratique, la qualité baisse bien avant la limite annoncée. D’où l’intérêt du RAG : retrouver les quelques passages utiles et n’envoyer qu’eux.
Comment le modèle a appris
Il reste une question : d’où viennent tous ces poids, ces embeddings, ces matrices de requêtes et de clés ? De l’entraînement, en trois temps.
1. Le pré-entraînement : deviner la suite, des milliers de milliards de fois
On montre au modèle d’immenses volumes de texte, et à chaque position il doit deviner le token suivant. Les exercices se fabriquent seuls : il suffit de décaler le texte d’un cran.
Une phrase, quatre exercices, sans aucune annotation humaine.
Les volumes donnent le vertige : 15 000 milliards de tokens pour Llama 3, 36 000 milliards pour Qwen3. DeepSeek-V3 a demandé près de 2,8 millions d’heures de GPU.
Grâce au masque causal, une seule phrase fournit tous ses exercices en un seul passage : chaque position ne voit que son passé, comme si on posait toutes les questions en même temps.
Mesurer l’erreur, corriger les poids
À chaque position, on regarde la probabilité que le modèle a donnée au bon token. C’est la loss : moins de chances accordées à la bonne réponse, plus la pénalité est forte.
- Le modèle donnait 54 % à « trois », et c’était la bonne réponse : petite pénalité (0,6).
- Il ne lui donnait que 5 % : grosse pénalité (3,0).
Puis la rétropropagation remonte l’erreur à travers toutes les couches et ajuste très légèrement chaque poids dans le bon sens. Répété des milliards de fois, on obtient un modèle de base : il complète du texte à merveille, mais ne sait pas encore converser.
2. Le mid-training : se spécialiser
On continue le même exercice, mais sur des données choisies :
- des textes de meilleure qualité, du code, des mathématiques ;
- des raisonnements détaillés, étape par étape ;
- des documents très longs, pour étendre la fenêtre de contexte, en ajustant au passage les positions RoPE.
3. Le post-entraînement : devenir un assistant
- Le fine-tuning sur instructions (SFT) : des milliers d’exemples de demandes et de bonnes réponses, dans le format de conversation du modèle, avec ses tokens spéciaux de début et de fin de message ;
- l’alignement sur les préférences : entre deux réponses, apprendre à préférer la meilleure, selon des humains ou un autre modèle ;
- le renforcement sur des tâches vérifiables (maths, code) : le modèle essaie, on vérifie le résultat, on récompense ce qui marche. C’est ainsi que naissent les modèles de raisonnement.
Ce que ça change pour vous
- La date de coupure : le modèle ignore tout ce qui est plus récent que ses données. Fournissez-le dans le contexte.
- Les hallucinations : il a appris à produire du texte plausible, pas forcément vrai. Une loss basse récompense la vraisemblance, pas l’exactitude. Donnez-lui des sources et vérifiez.
- Le fine-tuning apprend des comportements (ton, format, vocabulaire métier), beaucoup moins des faits nouveaux. Pour des faits, le RAG est presque toujours le bon outil.
Pour aller plus loin
- Les modèles de raisonnement écrivent une longue réflexion avant de répondre. Ce sont des tokens de sortie en plus, donc du decode en plus : meilleurs sur les problèmes complexes, mais plus lents et plus chers.
- Le speculative decoding accélère le decode : un petit modèle propose plusieurs tokens d’avance, et le gros les vérifie tous en un seul passage, comme un mini-prefill. Les tokens validés sont gardés, sans perte de qualité.
- Les agents combinent un modèle et des outils qu’il peut appeler, en boucle. Voir Workflows et agents IA : choisir selon le besoin.
- La quantization stocke les poids sur 8 ou 4 bits au lieu de 16 : moins de mémoire à relire à chaque token, donc un decode plus rapide.
- Les LLM à diffusion sont non autorégressifs : au lieu d’écrire token par token, ils affinent toute la réponse à chaque passage, comme les générateurs d’images. Une piste encore jeune pour échapper au goulot du decode.
Ce qu’il faut retenir
- Le principe : un LLM prédit un token à la fois, par tirage, et recommence. Tout le reste en découle.
- Coûts : vous payez en tokens, et ceux de sortie coûtent plus cher. Raccourcissez les réponses, ordonnez vos prompts pour le cache.
- Latence : le premier mot dépend du prefill, donc de la taille du prompt. La vitesse du flot dépend du decode. Streamez.
- Mémoire : chaque token de contexte occupe le GPU pendant toute la réponse. N’envoyez que l’utile.
- Fiabilité : température basse, sorties structurées, tests sur des jeux d’exemples, jamais sur un seul essai.
- Exactitude : le modèle vise le plausible. Des sources dans le contexte, et une vérification de ce qui compte.
Conclusion
Un LLM découpe votre texte en tokens, les traduit en vecteurs, les fait dialoguer couche après couche, puis transforme le dernier vecteur en probabilités et tire un token. Un seul. Il le garde en mémoire avec tout le reste, et recommence.
Le prix au token, le silence avant le premier mot, la vitesse du flot, les réponses qui varient, le poids des longs contextes, la puissance du cache : tout découle de cette boucle. La comprendre, c’est concevoir ses projets d’IA en connaissance de cause, et savoir où chercher quand la facture ou la latence dérapent.
Vous concevez un assistant, un RAG ou un agent ? Les experts Logbrain vous accompagnent, de l’architecture à la mise en production. Parlons de votre projet