
La scène est familière. La facture cloud du trimestre arrive, elle dépasse le budget de 30 %, et la direction financière demande des explications. Commence alors une chasse au gaspillage menée dans l’urgence : on éteint quelques machines oubliées, on négocie avec le fournisseur, on promet de « faire attention ». Trois mois plus tard, la facture est repartie à la hausse.
Ce scénario se répète parce qu’il traite le problème au mauvais endroit. Dans le cloud, la dépense n’est pas décidée par le service achats, elle est décidée par chaque ligne de code, chaque fichier Terraform et chaque choix d’architecture. Une taille d’instance, une politique de rétention, un cluster qui ne s’arrête jamais le week-end : ce sont des décisions d’ingénieurs, prises des dizaines de fois par jour.
C’est pourquoi le FinOps n’est pas un sujet financier, c’est un sujet d’ingénierie. La finance a un rôle essentiel à jouer (budgéter, prévoir, arbitrer), mais les économies durables se construisent là où se prennent les décisions techniques. Voici comment l’aborder.
Pourquoi les coûts cloud dérapent
Le cloud a supprimé la friction qui, autrefois, limitait naturellement la dépense. Commander un serveur prenait des semaines et passait par un processus d’achat. Aujourd’hui, il suffit d’un appel d’API. Cette agilité est précieuse, mais elle a des effets secondaires bien connus.
- Le surdimensionnement par précaution. Faute de données sur la charge réelle, on choisit la taille « au-dessus » pour ne pas prendre de risque. Puis personne ne revient sur ce choix.
- Les ressources orphelines. Environnements de test jamais détruits, volumes détachés, snapshots accumulés, adresses IP réservées : ils ne servent plus à rien mais continuent d’être facturés.
- Le tarif à la demande par défaut. Le prix on-demand est le plus cher du catalogue. C’est pourtant celui que paient de nombreuses organisations sur des charges qui tournent 24 h/24 depuis des années.
- Des données qu’on n’efface jamais. Le stockage paraît bon marché au gigaoctet. Multiplié par des pétaoctets conservés indéfiniment dans la classe la plus performante, il devient un poste majeur, en particulier pour les plateformes data.
- Une facture illisible pour ceux qui la génèrent. Les ingénieurs ne voient pas la facture, et ceux qui la voient ne savent pas à quoi correspond chaque ligne. Personne n’est donc en position d’agir.
Aucune de ces causes ne se règle par une négociation commerciale. Toutes se règlent par des pratiques d’ingénierie.
Les leviers les plus impactants
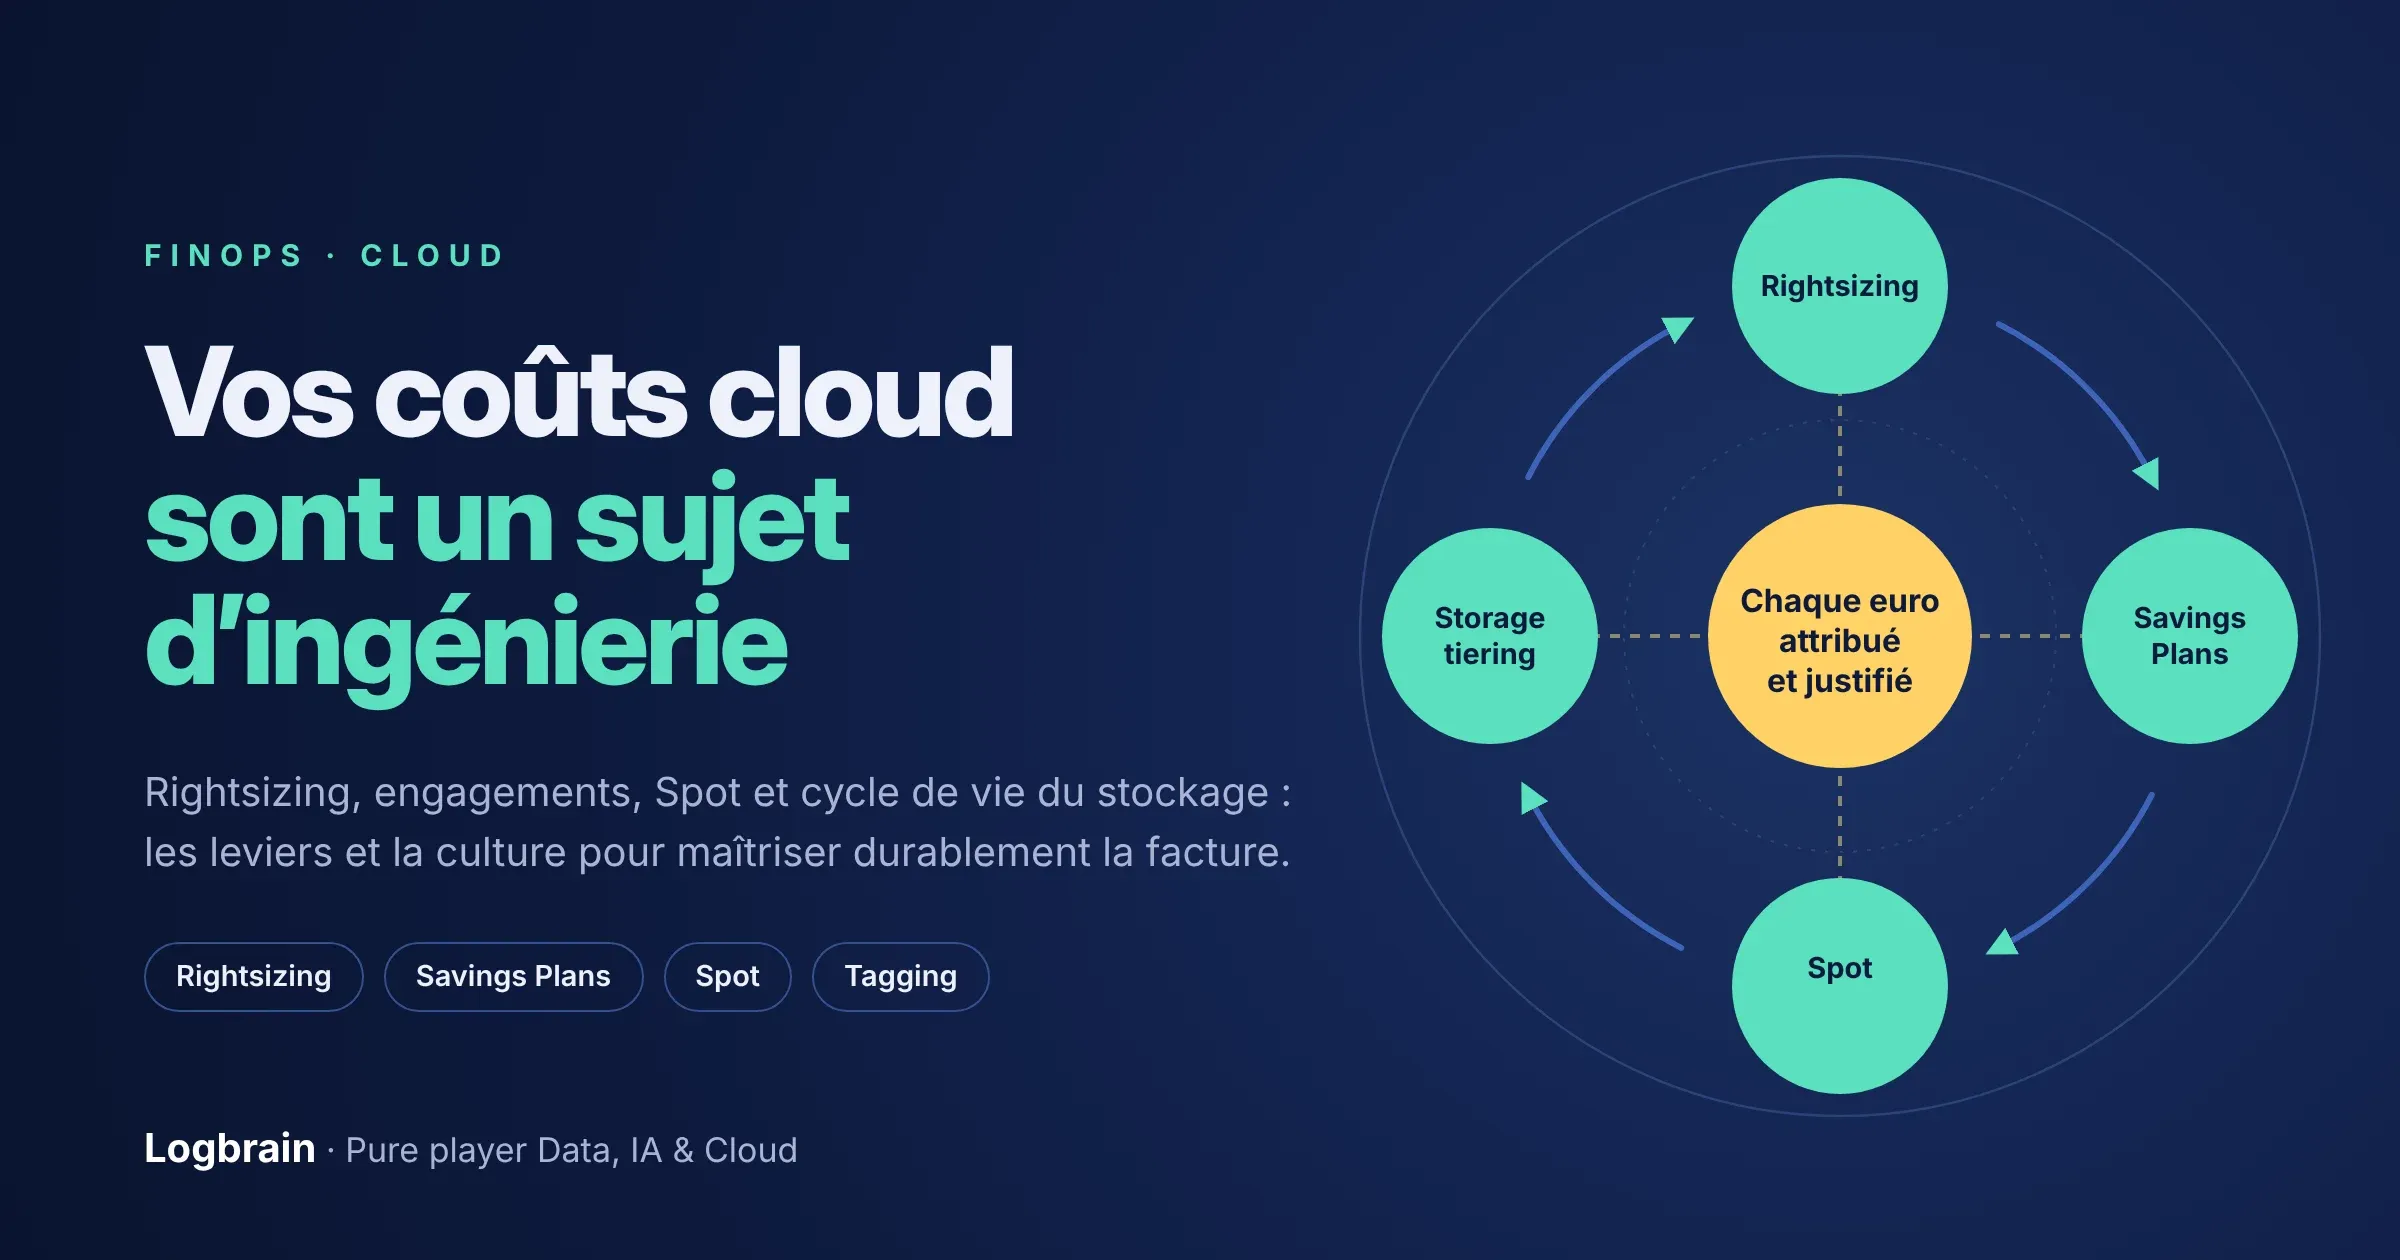
Il existe des dizaines d’optimisations possibles. Quatre leviers concentrent l’essentiel des gains, et ils se combinent.
1. Le rightsizing : payer pour ce qu’on utilise vraiment
Beaucoup d’instances sont surdimensionnées. L’analyse des métriques d’utilisation (CPU, mémoire, réseau, IOPS) révèle souvent 40 à 60 % de capacité inutilisée. Une machine dont le processeur plafonne à 15 % sur trente jours peut, dans la majorité des cas, descendre d’une ou deux tailles sans aucun impact sur le service.
Les outils natifs fournissent un premier diagnostic : AWS Compute Optimizer, Azure Advisor, les recommandations de Google Cloud Recommender. Ils ont cependant une limite : ils ne connaissent pas le contexte. Une base de données peu sollicitée en semaine peut encaisser un pic critique en fin de mois. Le rightsizing reste donc une décision d’ingénieur, éclairée par les données.
Quelques bonnes pratiques :
- Observer sur une période représentative (au moins deux à quatre semaines, en incluant les pics métier) et raisonner sur des percentiles élevés plutôt que sur des moyennes.
- Regarder la mémoire, pas seulement le CPU : sur AWS, elle n’est remontée qu’avec l’agent CloudWatch, et c’est souvent elle qui justifie la taille choisie.
- Profiter du redimensionnement pour changer de génération ou de famille : les générations récentes, et les processeurs ARM comme AWS Graviton, offrent fréquemment un meilleur rapport performance/prix.
- Appliquer la même logique aux conteneurs : sur Kubernetes, des requests CPU et mémoire surestimées gaspillent des nœuds entiers, même si chaque pod paraît raisonnable.
- Éteindre ce qui n’a pas besoin de tourner : un environnement de développement utilisé 50 heures par semaine n’a aucune raison d’être facturé 168 heures.
2. Reserved Instances et Savings Plans : s’engager sur le socle stable
Pour les workloads stables, le tarif à la demande est un luxe inutile. Les engagements sur un à trois ans génèrent des économies de 40 à 70 % par rapport à l’on-demand. Chaque fournisseur a ses mécanismes : Reserved Instances et Savings Plans chez AWS, Reservations et Savings Plan for Compute chez Azure, Committed Use Discounts chez Google Cloud.
La difficulté n’est pas de comprendre le principe, c’est de bien dimensionner l’engagement. S’engager trop peu laisse de l’argent sur la table ; s’engager trop engage l’entreprise à payer une capacité qu’elle n’utilisera pas.
- Ne couvrir que le socle de consommation observé sur plusieurs mois, pas le pic. Le reste continue de relever de l’on-demand ou du Spot.
- Faire le rightsizing avant de s’engager. Réserver une capacité surdimensionnée revient à figer le gaspillage pour trois ans.
- Privilégier la flexibilité quand l’architecture évolue : un Compute Savings Plan s’applique quelle que soit la famille d’instance ou la région, au prix d’une remise un peu moindre qu’un engagement très spécifique.
- Échelonner les engagements plutôt que tout acheter le même jour, pour pouvoir ajuster la couverture au fil des renouvellements.
- Suivre deux indicateurs : le taux de couverture (quelle part de la consommation éligible est sous engagement) et le taux d’utilisation (quelle part de l’engagement est réellement consommée).
3. Les instances Spot : la capacité excédentaire au prix fort réduit
Les fournisseurs revendent leur capacité inutilisée avec des remises très importantes, en contrepartie d’un droit de reprise avec un court préavis (deux minutes chez AWS, une trentaine de secondes chez Azure et Google Cloud). Pour les workloads de data engineering et de machine learning, les instances Spot peuvent diviser les coûts par 5.
Ces charges s’y prêtent particulièrement bien, car elles sont souvent par lots, parallélisables et capables de reprendre là où elles s’étaient arrêtées : traitements Spark, transformations nocturnes, entraînements de modèles, calculs de features, tests de charge. La condition est de les concevoir pour l’interruption :
- Rendre les traitements idempotents et rejouables, et sauvegarder régulièrement l’état (checkpointing) pour les entraînements longs.
- Diversifier les types d’instances et les zones de disponibilité pour limiter le risque de reprise simultanée de toute la capacité.
- Mixer Spot et on-demand : le nœud maître d’un cluster Spark ou le plan de contrôle reste sur une capacité garantie, les workers passent en Spot.
- S’appuyer sur les outils qui gèrent l’interruption nativement : groupes d’instances mixtes, Karpenter sur Kubernetes, Spot VMs de Databricks ou d’EMR, managed spot training de SageMaker.
À l’inverse, le Spot n’a rien à faire sous une base de données de production ou une API exposée aux clients sans architecture conçue pour le supporter.
4. Le storage tiering : automatiser le cycle de vie des données
Toutes les données n’ont pas besoin du même niveau de service. Un fichier brut ingéré il y a deux ans et jamais relu depuis n’a pas à être stocké dans la classe la plus rapide et la plus chère. Automatiser le cycle de vie des données réduit considérablement les coûts de stockage, d’autant plus que les plateformes data accumulent les volumes historiques.
Deux approches complémentaires existent :
- Le tiering automatique : S3 Intelligent-Tiering déplace chaque objet vers des niveaux d’accès moins coûteux selon son usage réel, sans frais de récupération. C’est la bonne option quand les schémas d’accès sont imprévisibles. Attention toutefois aux très petits objets, qui ne sont pas éligibles au déplacement automatique, et aux frais de supervision par objet sur des volumes de millions de fichiers.
- Les politiques de cycle de vie explicites : S3 Lifecycle ou Azure Blob Lifecycle Management déplacent les données vers des classes froides ou d’archive, puis les suppriment, selon des règles d’âge. C’est la bonne option quand les règles sont connues : une zone raw conservée 90 jours en classe chaude, puis archivée, puis supprimée à l’échéance de la durée légale de conservation.
{
  "rules": [
    {
      "name": "raw-zone-lifecycle",
      "enabled": true,
      "type": "Lifecycle",
      "definition": {
        "filters": { "blobTypes": ["blockBlob"], "prefixMatch": ["datalake/raw/"] },
        "actions": {
          "baseBlob": {
            "tierToCool": { "daysAfterModificationGreaterThan": 30 },
            "tierToArchive": { "daysAfterModificationGreaterThan": 180 },
            "delete": { "daysAfterModificationGreaterThan": 2555 }
          }
        }
      }
    }
  ]
}
Le stockage ne se limite pas aux buckets : snapshots, sauvegardes, versions d’objets, time travel des tables lakehouse et tables temporaires d’entrepôts méritent les mêmes règles de rétention. Et les classes d’archive ont des frais et des délais de restitution : le tiering doit être aligné sur les vrais besoins de consultation, pas seulement sur l’âge des fichiers.
Notre recommandation : traitez ces quatre leviers dans l’ordre. Supprimez d’abord ce qui ne sert plus, redimensionnez ce qui reste, puis engagez-vous sur le socle stable et basculez les traitements interruptibles en Spot. Le stockage se traite en parallèle, car il ne dépend pas des autres. Inverser l’ordre, en achetant des engagements avant d’avoir nettoyé, est l’erreur la plus coûteuse que nous rencontrons.
La culture FinOps : rendre les coûts visibles et actionnables
Les optimisations techniques produisent des gains rapides. Mais sans changement de pratiques, le gaspillage se reconstitue au rythme des nouveaux déploiements. Au-delà des optimisations ponctuelles, la culture FinOps consiste à rendre les coûts visibles et actionnables pour les équipes engineering. L’objectif est simple à formuler : chaque développeur doit connaître le coût de ce qu’il déploie.
Le cadre de la FinOps Foundation décrit ce mouvement en trois phases qui se répètent en boucle : informer (rendre la dépense visible et attribuable), optimiser (agir sur les leviers) et opérer (intégrer la maîtrise des coûts dans les processus courants). Concrètement, trois pratiques font la différence.
Un tagging systématique
Impossible de responsabiliser une équipe sur une dépense qu’on ne sait pas lui attribuer. Le tagging est le fondement de toute démarche FinOps, et il doit être traité comme une exigence technique, pas comme une bonne intention.
- Définir un socle de tags obligatoires et court : équipe propriétaire, application ou data product, environnement, centre de coût.
- L’imposer dans l’infrastructure as code : tags par défaut au niveau du provider Terraform, contrôles en CI qui refusent une ressource non taguée.
- Le faire respecter côté plateforme : AWS Tag Policies et Service Control Policies, Azure Policy, contraintes d’organisation sur Google Cloud.
- Gérer ce qui ne se tague pas (trafic réseau partagé, support, ressources mutualisées) avec des règles de répartition explicites et connues de tous.
Des dashboards par équipe
Une facture globale n’apprend rien à personne. Ce qui change les comportements, c’est de voir sa propre dépense, son évolution et ses causes, dans un tableau de bord que l’équipe consulte vraiment.
- Le showback d’abord : chaque équipe voit ce qu’elle coûte, sans refacturation. Le chargeback (refacturation interne) vient ensuite, si l’organisation le souhaite.
- Des indicateurs unitaires plutôt que des montants bruts : coût par transaction, par client actif, par pipeline exécuté, par millier de requêtes d’inférence. Une facture qui augmente n’est pas un problème si l’activité augmente plus vite ; un coût unitaire qui dérive en est un.
- Des données de coût traitées comme des données : les exports détaillés des fournisseurs (AWS Cost and Usage Report, exports Azure Cost Management, export de facturation vers BigQuery) chargés dans la plateforme data, idéalement normalisés au format ouvert FOCUS pour consolider plusieurs clouds.
- Le coût au moment de la décision : des outils comme Infracost affichent dans la pull request l’impact financier d’une modification Terraform, avant son déploiement.
Des alertes budgétaires et la détection d’anomalies
Découvrir une dérive sur la facture mensuelle, c’est la découvrir trente jours trop tard. Les alertes doivent prévenir l’équipe responsable, pas seulement la direction financière.
- Des budgets par équipe ou par projet, avec des alertes sur le réel et sur la projection de fin de mois (AWS Budgets, budgets Azure Cost Management, budgets Google Cloud).
- La détection d’anomalies (AWS Cost Anomaly Detection, alertes d’anomalies Azure) pour repérer la boucle infinie, la requête mal écrite ou le cluster oublié en quelques heures plutôt qu’en quelques semaines.
- Des alertes routées vers les canaux des équipes, avec un propriétaire identifié, exactement comme les alertes de production.
Notre recommandation : commencez par la visibilité, pas par l’injonction. Une équipe qui découvre son propre coût unitaire, sans reproche, trouve presque toujours d’elle-même des optimisations que personne d’autre n’aurait identifiées. Les ingénieurs aiment résoudre des problèmes ; encore faut-il leur montrer celui-ci.
Les pièges à éviter
Piège n°1 : faire du FinOps une affaire d’un seul service
Confier le FinOps uniquement à la finance produit des tableaux que les ingénieurs ne lisent pas. Le confier uniquement à une équipe cloud centrale produit des optimisations que les équipes produit défont au déploiement suivant. Le FinOps fonctionne quand la finance, la plateforme et les équipes engineering partagent les mêmes chiffres et les mêmes objectifs.
Piège n°2 : l’opération coup de poing
Le grand ménage annuel donne de beaux résultats ponctuels, puis la dépense remonte. Les économies durables viennent de garde-fous intégrés au quotidien : tags obligatoires, politiques de cycle de vie par défaut, arrêt automatique des environnements hors usage, revue des coûts dans les rituels d’équipe.
Piège n°3 : optimiser au détriment du service
Réduire les coûts n’est pas un objectif en soi. Une base de données sous-dimensionnée qui dégrade l’expérience client, ou des sauvegardes supprimées pour économiser quelques euros, coûtent bien plus que ce qu’elles font gagner. Le bon indicateur n’est pas la facture la plus basse, c’est le meilleur coût unitaire à niveau de service maîtrisé.
FinOps, data et IA : une urgence nouvelle
Les plateformes data et les projets d’IA sont aujourd’hui parmi les premiers postes de dépense cloud, et parmi les plus difficiles à prévoir. Un entrepôt facturé à la requête, un cluster Spark mal paramétré ou un index vectoriel reconstruit inutilement peuvent faire exploser un budget en quelques jours. L’IA générative ajoute des GPU rares et chers, et une facturation à l’usage des modèles (au token) qui croît avec l’adoption.
Les mêmes principes s’appliquent, adaptés à ces nouveaux usages : rightsizing des clusters et des entrepôts (taille, auto-suspension, auto-scaling), Spot pour les entraînements et les traitements par lots, cycle de vie du stockage pour les zones raw et les jeux d’entraînement, et indicateurs unitaires comme le coût par requête ou par conversation. Choisir un modèle plus léger quand il suffit, mettre en cache les réponses fréquentes ou limiter le contexte transmis sont aujourd’hui des décisions FinOps à part entière.
Les organisations qui maîtrisent le coût unitaire de leurs cas d’usage d’IA peuvent les passer à l’échelle en confiance. Les autres découvrent, au moment du déploiement généralisé, que le prototype prometteur n’a pas de modèle économique.
Où en êtes-vous ?
Quelques questions pour évaluer rapidement votre maturité FinOps :
- Pouvez-vous attribuer plus de 90 % de votre facture cloud à une équipe, une application ou un data product ?
- Vos équipes engineering voient-elles leur propre dépense, au moins chaque semaine, sans avoir à la demander ?
- Connaissez-vous le coût unitaire de vos principaux services (par client, par transaction, par pipeline) ?
- Quelle part de votre consommation stable est couverte par des engagements, et quel est leur taux d’utilisation ?
- Vos traitements data et vos entraînements ML tournent-ils en Spot quand ils le peuvent ?
- Vos buckets et vos data lakes ont-ils des politiques de cycle de vie, ou les données s’y accumulent-elles sans limite ?
- Combien de temps faut-il pour détecter une dérive de coût, et qui est prévenu en premier ?
Si plusieurs réponses sont négatives, les premiers gains sont généralement rapides et autofinancent la suite de la démarche : un nettoyage des ressources orphelines, une campagne de rightsizing et une première couverture du socle par des engagements dégagent souvent des économies significatives en quelques semaines.
Conclusion
Le FinOps n’est pas un exercice de réduction de coûts mené une fois par an par la direction financière. C’est une discipline d’ingénierie, qui consiste à traiter le coût comme une métrique de production, au même titre que la latence, la disponibilité ou la qualité des données.
Rightsizing pour payer ce qu’on utilise, engagements pour le socle stable, Spot pour les traitements interruptibles, cycle de vie pour le stockage : ces leviers techniques produisent les gains. Le tagging, les dashboards par équipe et les alertes budgétaires les rendent durables. Ensemble, ils transforment la facture cloud d’une mauvaise surprise trimestrielle en un paramètre que chaque équipe pilote.
La question n’est plus « combien nous coûte le cloud ? », mais « combien nous coûte chaque service que nous rendons, et qui est en mesure de l’améliorer ? »
Vous souhaitez reprendre le contrôle de votre facture cloud ou installer une démarche FinOps durable dans vos équipes ? Les experts Logbrain, pure player data, IA et cloud, vous accompagnent de l’audit de vos dépenses à la mise en place du tagging, des tableaux de bord et des optimisations sur AWS, Azure et Google Cloud. Contactez-nous.