Data Mesh : au-delà du buzz, ce qui marche vraiment sur le terrain
Quatre principes, trois pièges, et les leçons de trois déploiements réels dans la banque, l’industrie et le retail.
Depuis que Zhamak Dehghani a formalisé le concept en 2019, le Data Mesh est passé du statut d’idée provocante à celui de mot d’ordre dans les comités de direction. Peu de paradigmes data ont suscité autant d’enthousiasme, ni autant de désillusions. Les analystes du marché eux-mêmes se sont montrés prudents : certains ont prédit que le Data Mesh deviendrait obsolète avant même d’atteindre sa maturité, d’autres y voient l’évolution naturelle du data management à l’échelle.
Alors, mode passagère ou véritable changement de modèle ? Notre réponse, tirée du terrain, est nuancée : le Data Mesh n’est pas une architecture qu’on achète, c’est un modèle opérationnel qu’on construit. Et c’est précisément là que la plupart des organisations se trompent.
Pourquoi le Data Mesh est apparu
Pour comprendre le Data Mesh, il faut d’abord comprendre l’impasse qu’il cherche à résoudre.
Pendant vingt ans, la réponse à la question « comment exploiter nos données ? » a été la centralisation : un data warehouse, puis un data lake, puis un lakehouse, alimentés et gérés par une équipe data centrale. Ce modèle fonctionne très bien… jusqu’à un certain point.
Au-delà d’une certaine taille, l’équipe centrale devient un goulot d’étranglement. Elle reçoit des demandes de tous les métiers, ne maîtrise pas le sens profond des données qu’elle manipule, et passe son temps à réparer des pipelines cassés par des changements dont personne ne l’a prévenue. Les métiers, eux, attendent des semaines pour un nouvel indicateur et finissent par contourner le système avec leurs propres extractions Excel.
Le résultat est connu : un lac de données coûteux, une confiance faible dans les chiffres, et un time-to-insight qui ne suit plus le rythme du business. Le Data Mesh part d’un constat simple : le problème n’est pas technologique, il est organisationnel.
Ce que le Data Mesh change vraiment
Contrairement aux approches centralisées, le Data Mesh repose sur quatre principes fondamentaux. Chacun est simple à énoncer, et exigeant à mettre en œuvre.
1. La propriété des données par domaine
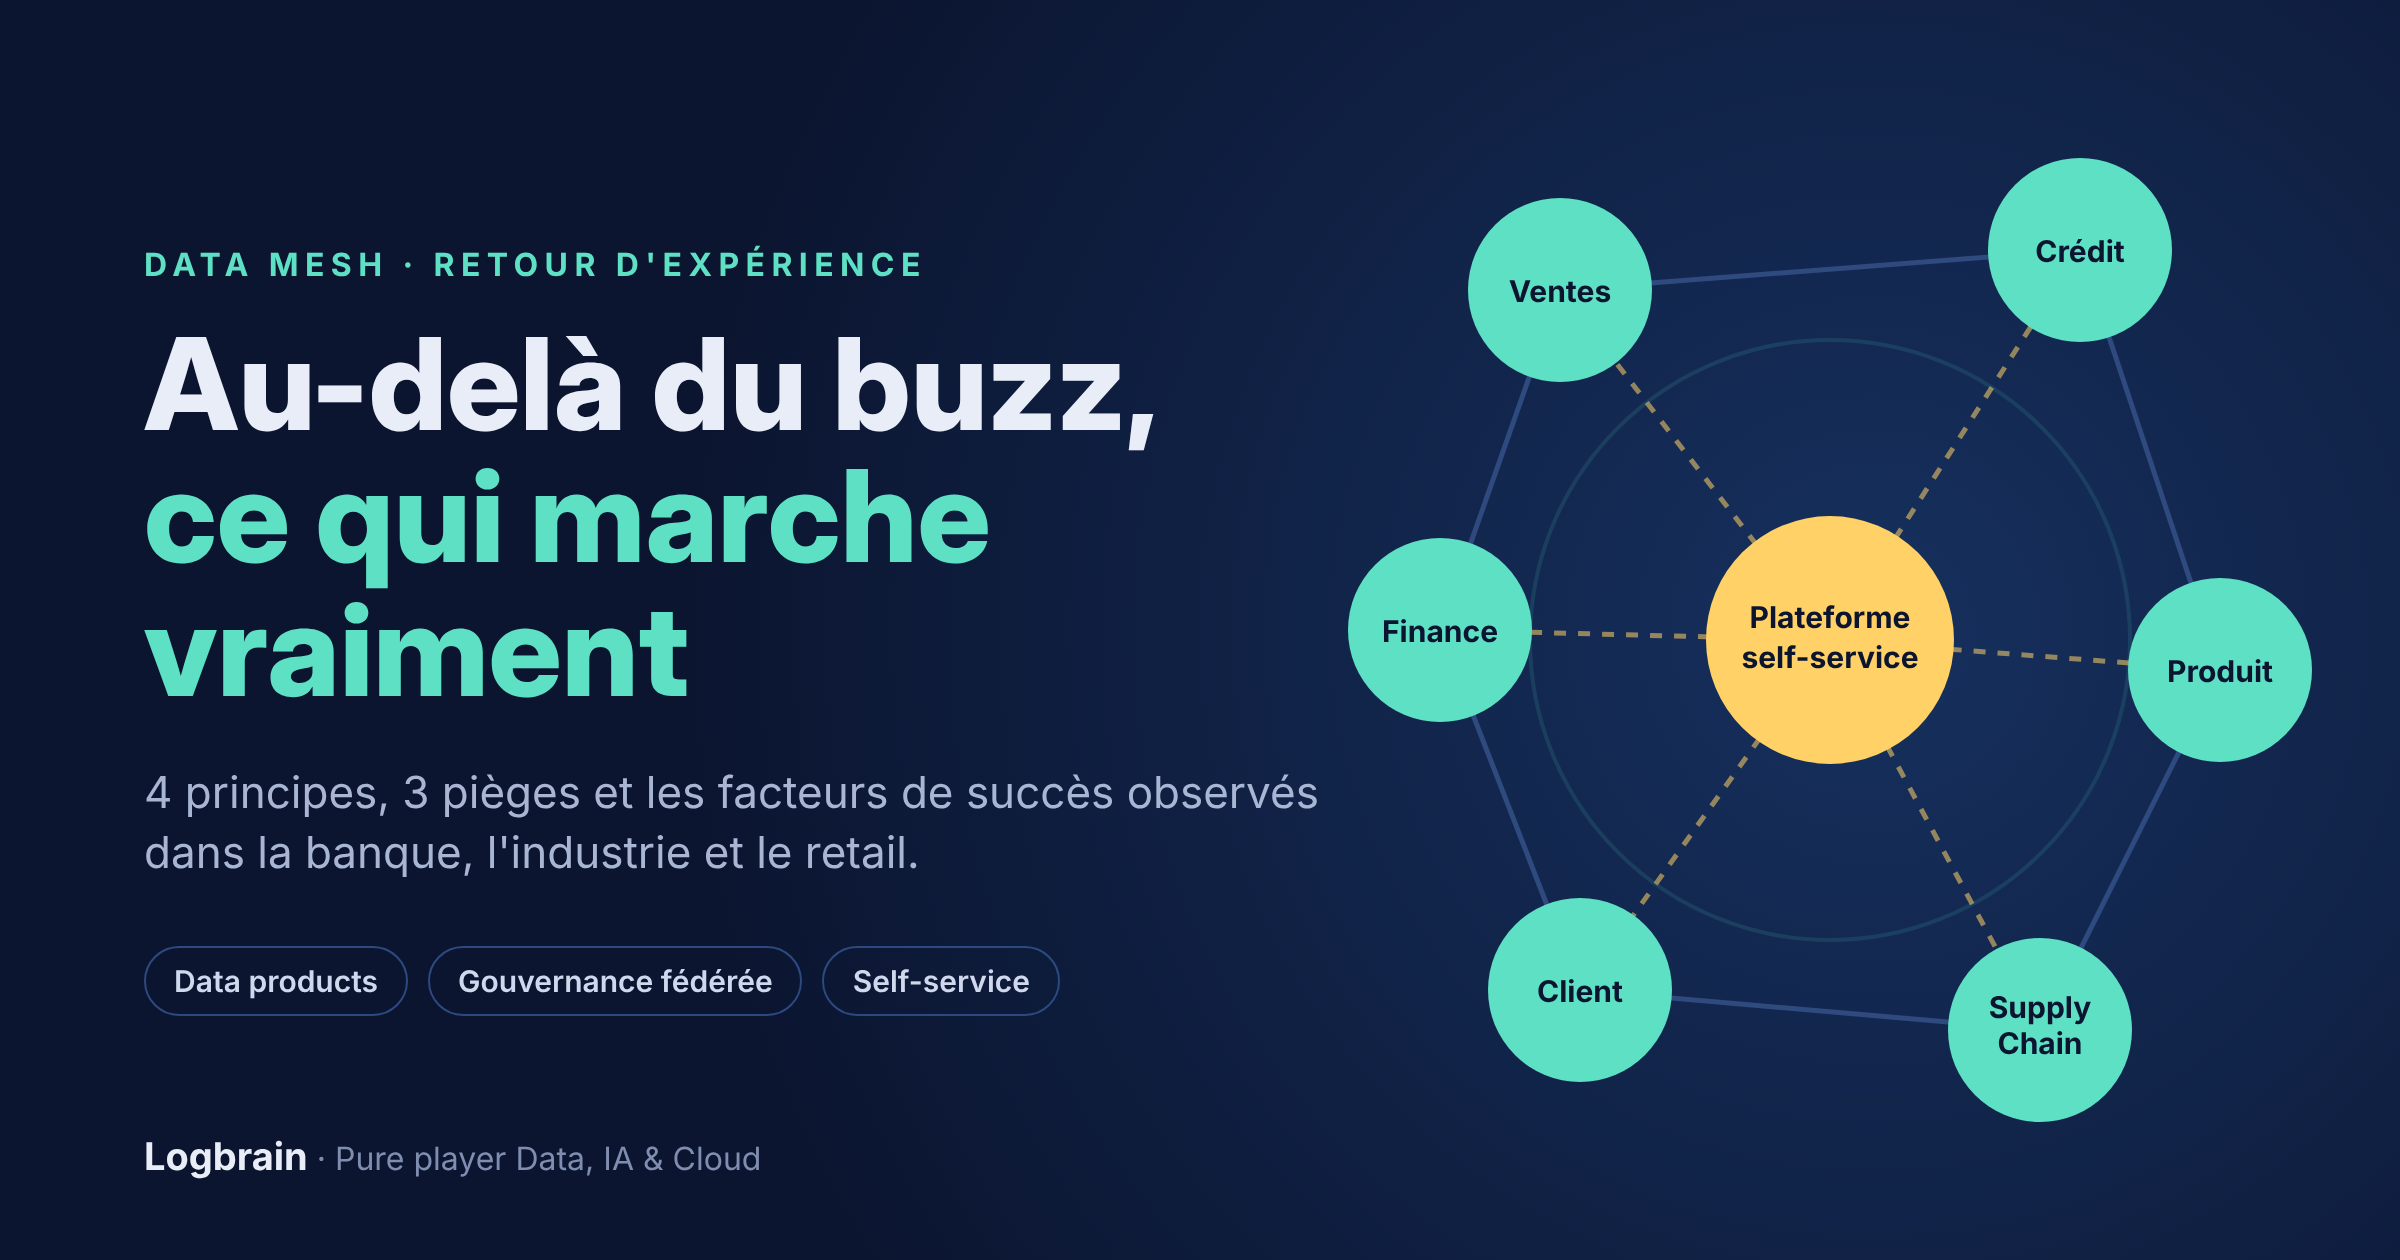
Les données sont gérées par les équipes qui les produisent et les comprennent le mieux : le domaine Crédit, le domaine Supply Chain, le domaine Client. Ce n’est plus l’équipe data centrale qui « possède » les données des ventes, c’est le domaine Ventes.
Ce que cela implique concrètement : un découpage clair des domaines, souvent inspiré du Domain-Driven Design, et des responsables nommés pour chaque périmètre.
2. Les données comme produit
Chaque domaine expose ses données sous forme de data products : des actifs documentés, fiables, découvrables et utilisables par d’autres, avec un niveau de service explicite. Un bon data product a un propriétaire, des utilisateurs identifiés, un contrat (schéma, fraîcheur, qualité) et une feuille de route.
Ce que cela implique concrètement : un rôle de Data Product Owner, des indicateurs de qualité suivis, et une logique de satisfaction des consommateurs, comme pour n’importe quel produit.
3. L’infrastructure self-service
Pour que chaque domaine puisse produire des data products sans devenir une équipe d’ingénierie de données à part entière, une équipe plateforme met à disposition des capacités standardisées : ingestion, stockage, transformation, catalogage, contrôle d’accès, observabilité.
Ce que cela implique concrètement : une plateforme pensée comme un produit interne, avec des golden paths qui rendent la bonne pratique plus facile que le contournement.
4. La gouvernance fédérée
La décentralisation n’est pas l’anarchie. Un cadre commun définit les règles qui s’appliquent à tous : standards d’interopérabilité, sécurité, conformité réglementaire, sémantique partagée. Ces règles sont décidées collectivement par les domaines et la plateforme, et autant que possible appliquées automatiquement par la plateforme (policy as code).
Ce que cela implique concrètement : une instance de gouvernance représentative, un nombre limité de règles non négociables, et leur automatisation.
L’essentiel : ces quatre principes forment un système. Retirer l’un d’eux fait s’effondrer les trois autres. Des domaines autonomes sans plateforme s’épuisent ; une plateforme sans data products est un data lake de plus ; des data products sans gouvernance fédérée ne communiquent pas entre eux.
En théorie, tout cela semble limpide. En pratique, ces principes impliquent une transformation organisationnelle profonde, qui touche aux rôles, aux budgets, aux incitations et à la culture.
Les pièges les plus courants
Piège n°1 : commencer par la technologie plutôt que par l’organisation
C’est l’erreur la plus fréquente, et la plus coûteuse. Séduites par le discours des éditeurs, beaucoup d’entreprises investissent dans des plateformes onéreuses avant d’avoir clarifié qui est responsable de quoi.
Le symptôme est reconnaissable : un programme baptisé « Data Mesh » dont le premier livrable est un appel d’offres technologique. Dix-huit mois plus tard, la plateforme est en place, mais aucun domaine ne s’en sert, faute de responsables, de compétences et de motivation.
Notre recommandation : commencez par la cartographie des domaines et des data products prioritaires. Nommez les propriétaires. La technologie viendra servir une organisation qui sait ce qu’elle veut, pas l’inverse. Une bonne question de départ : « Quels sont les cinq data products qui, demain, créeraient le plus de valeur, et qui en serait propriétaire ? »
Piège n°2 : sous-estimer le changement culturel
Le Data Mesh demande aux équipes métiers d’accepter de devenir propriétaires de leurs données, avec les responsabilités que cela implique : qualité, documentation, disponibilité, support aux consommateurs.
Pour beaucoup de directions métiers, c’est une charge nouvelle, perçue comme un transfert de travail de l’IT vers le métier. Sans contrepartie claire (budget, effectifs, reconnaissance, bénéfices visibles), la résistance est immédiate et légitime.
Notre recommandation : traitez le Data Mesh comme un programme de conduite du changement, pas comme un projet d’architecture. Intégrez les objectifs data dans les objectifs des domaines, financez les rôles de Data Product Owner, et montrez rapidement ce que le domaine y gagne en retour : plus d’autonomie, des délais plus courts, des cas d’usage IA qui deviennent enfin possibles.
Piège n°3 : négliger la gouvernance fédérée
Sans un cadre de gouvernance clair, le Data Mesh devient vite un data swamp décentralisé : chaque domaine publie ses données avec ses propres conventions, les identifiants clients ne se rapprochent plus, les définitions divergent (« un client actif », ça veut dire quoi chez vous ?), et la conformité RGPD devient impossible à démontrer.
L’erreur symétrique existe aussi : recréer une gouvernance centrale lourde, qui valide chaque data product en comité, et qui reconstruit exactement le goulot d’étranglement qu’on voulait supprimer.
Notre recommandation : définissez un socle minimal de règles non négociables (identifiants communs, classification des données sensibles, contrats de données, métadonnées obligatoires) et automatisez-les dans la plateforme. Tout le reste relève de l’autonomie des domaines. Une gouvernance qui ne s’automatise pas ne passe pas à l’échelle.
Les facteurs de succès : ce que nous avons observé sur le terrain
Nous avons accompagné trois déploiements de Data Mesh dans des contextes très différents : un acteur bancaire, un industriel et une enseigne de retail. Les enjeux n’étaient pas les mêmes (pression réglementaire pour la banque, données IoT et supply chain pour l’industriel, connaissance client omnicanale pour le retailer), mais les succès partagent trois points communs.
1. Un sponsor C-level fort
Le Data Mesh redistribue les responsabilités, les budgets et parfois le pouvoir. Aucune équipe data, aussi compétente soit-elle, ne peut imposer seule ce changement aux directions métiers. Dans les trois cas, un membre du comité exécutif (CDO rattaché à la direction générale, COO ou DSI au périmètre élargi) a porté le programme, arbitré les conflits de périmètre et protégé le budget pendant les phases moins visibles.
Le signal à surveiller : si votre sponsor n’est pas capable d’expliquer en deux phrases pourquoi l’entreprise s’engage dans le Data Mesh, le programme est en danger.
2. Des équipes domaines formées et impliquées dès le départ
Les domaines qui ont réussi n’ont pas « reçu » le Data Mesh, ils l’ont co-construit. Ils ont participé au découpage des domaines, à la définition des premiers data products et aux règles de gouvernance. Ils ont aussi bénéficié de formations concrètes : qu’est-ce qu’un data product, comment écrire un contrat de données, comment mesurer la qualité.
Une pratique qui a fait ses preuves : démarrer avec un ou deux domaines pilotes volontaires, à forte valeur et à maturité data suffisante, puis utiliser leur réussite comme vitrine pour embarquer les suivants.
3. Une plateforme self-service vraiment utilisable
« Self-service » est sans doute le terme le plus galvaudé de l’écosystème data. Une plateforme réellement self-service permet à une équipe domaine de créer, publier et monitorer un data product sans ouvrir de ticket. Dans nos trois déploiements, la plateforme a été gérée comme un produit, avec sa propre équipe, ses utilisateurs internes, ses indicateurs d’adoption et un vrai souci de l’expérience développeur.
L’indicateur clé : le temps nécessaire pour qu’une équipe domaine publie son premier data product en production. S’il se compte en mois, la plateforme n’est pas encore self-service.
Data Mesh et IA : un alignement naturel
Un point mérite d’être souligné, car il change la donne en 2026 : l’accélération des cas d’usage d’IA générative et d’IA agentique rend les principes du Data Mesh plus pertinents que jamais.
Les modèles et les agents IA ont besoin de données fiables, documentées, contextualisées et gouvernées. C’est exactement la définition d’un bon data product. Les métadonnées, la sémantique partagée et les contrats de données que le Data Mesh impose sont précisément ce qui permet à un assistant IA de trouver la bonne donnée, de la comprendre et de l’utiliser à bon escient. À l’inverse, un data swamp alimentant une IA ne produit que des réponses confiantes et fausses.
Autrement dit, les organisations qui investissent aujourd’hui dans des data products de qualité ne construisent pas seulement leur architecture data : elles préparent leur capacité à industrialiser l’IA.
Le Data Mesh est-il fait pour vous ?
Le Data Mesh n’est pas une solution universelle. Avant de vous lancer, posez-vous honnêtement ces questions :
- Votre organisation est-elle de taille significative, avec plusieurs domaines métiers distincts produisant et consommant des données ?
- Votre équipe data centrale est-elle devenue un goulot d’étranglement identifié par les métiers ?
- Vos domaines métiers sont-ils clairement délimités et disposent-ils d’une maturité data minimale ?
- Avez-vous un sponsor exécutif prêt à porter une transformation de plusieurs années ?
- Êtes-vous prêts à investir dans une équipe plateforme gérée comme une équipe produit ?
Si vous répondez « non » à la majorité de ces questions, une architecture centralisée bien gouvernée, éventuellement enrichie de certaines pratiques issues du Data Mesh (data products, contrats de données), sera probablement plus efficace et moins risquée. Le Data Mesh n’est pas un dogme : ses principes peuvent être adoptés progressivement et partiellement.
Conclusion
Le Data Mesh a souffert de son propre succès médiatique. Présenté comme une architecture à acheter, il a déçu. Compris comme ce qu’il est vraiment, un modèle opérationnel qui rapproche la responsabilité des données de ceux qui les connaissent, il tient ses promesses.
Pour les organisations de taille significative, avec des silos métiers bien définis, c’est une approche qui délivre : à condition de commencer par l’organisation plutôt que par la technologie, d’investir dans la culture autant que dans la plateforme, et de bâtir une gouvernance fédérée à la fois légère et automatisée.
La question n’est donc plus « faut-il faire du Data Mesh ? », mais « quels principes du Data Mesh peuvent créer de la valeur dans notre contexte, et dans quel ordre ? »
Vous envisagez une démarche Data Mesh ou souhaitez évaluer la maturité de votre organisation ? Les experts Logbrain, pure player data, IA et cloud, vous accompagnent du cadrage organisationnel à la mise en place de votre plateforme self-service. Parlons de votre situation