DataOps : appliquer enfin les pratiques DevOps à la data engineering
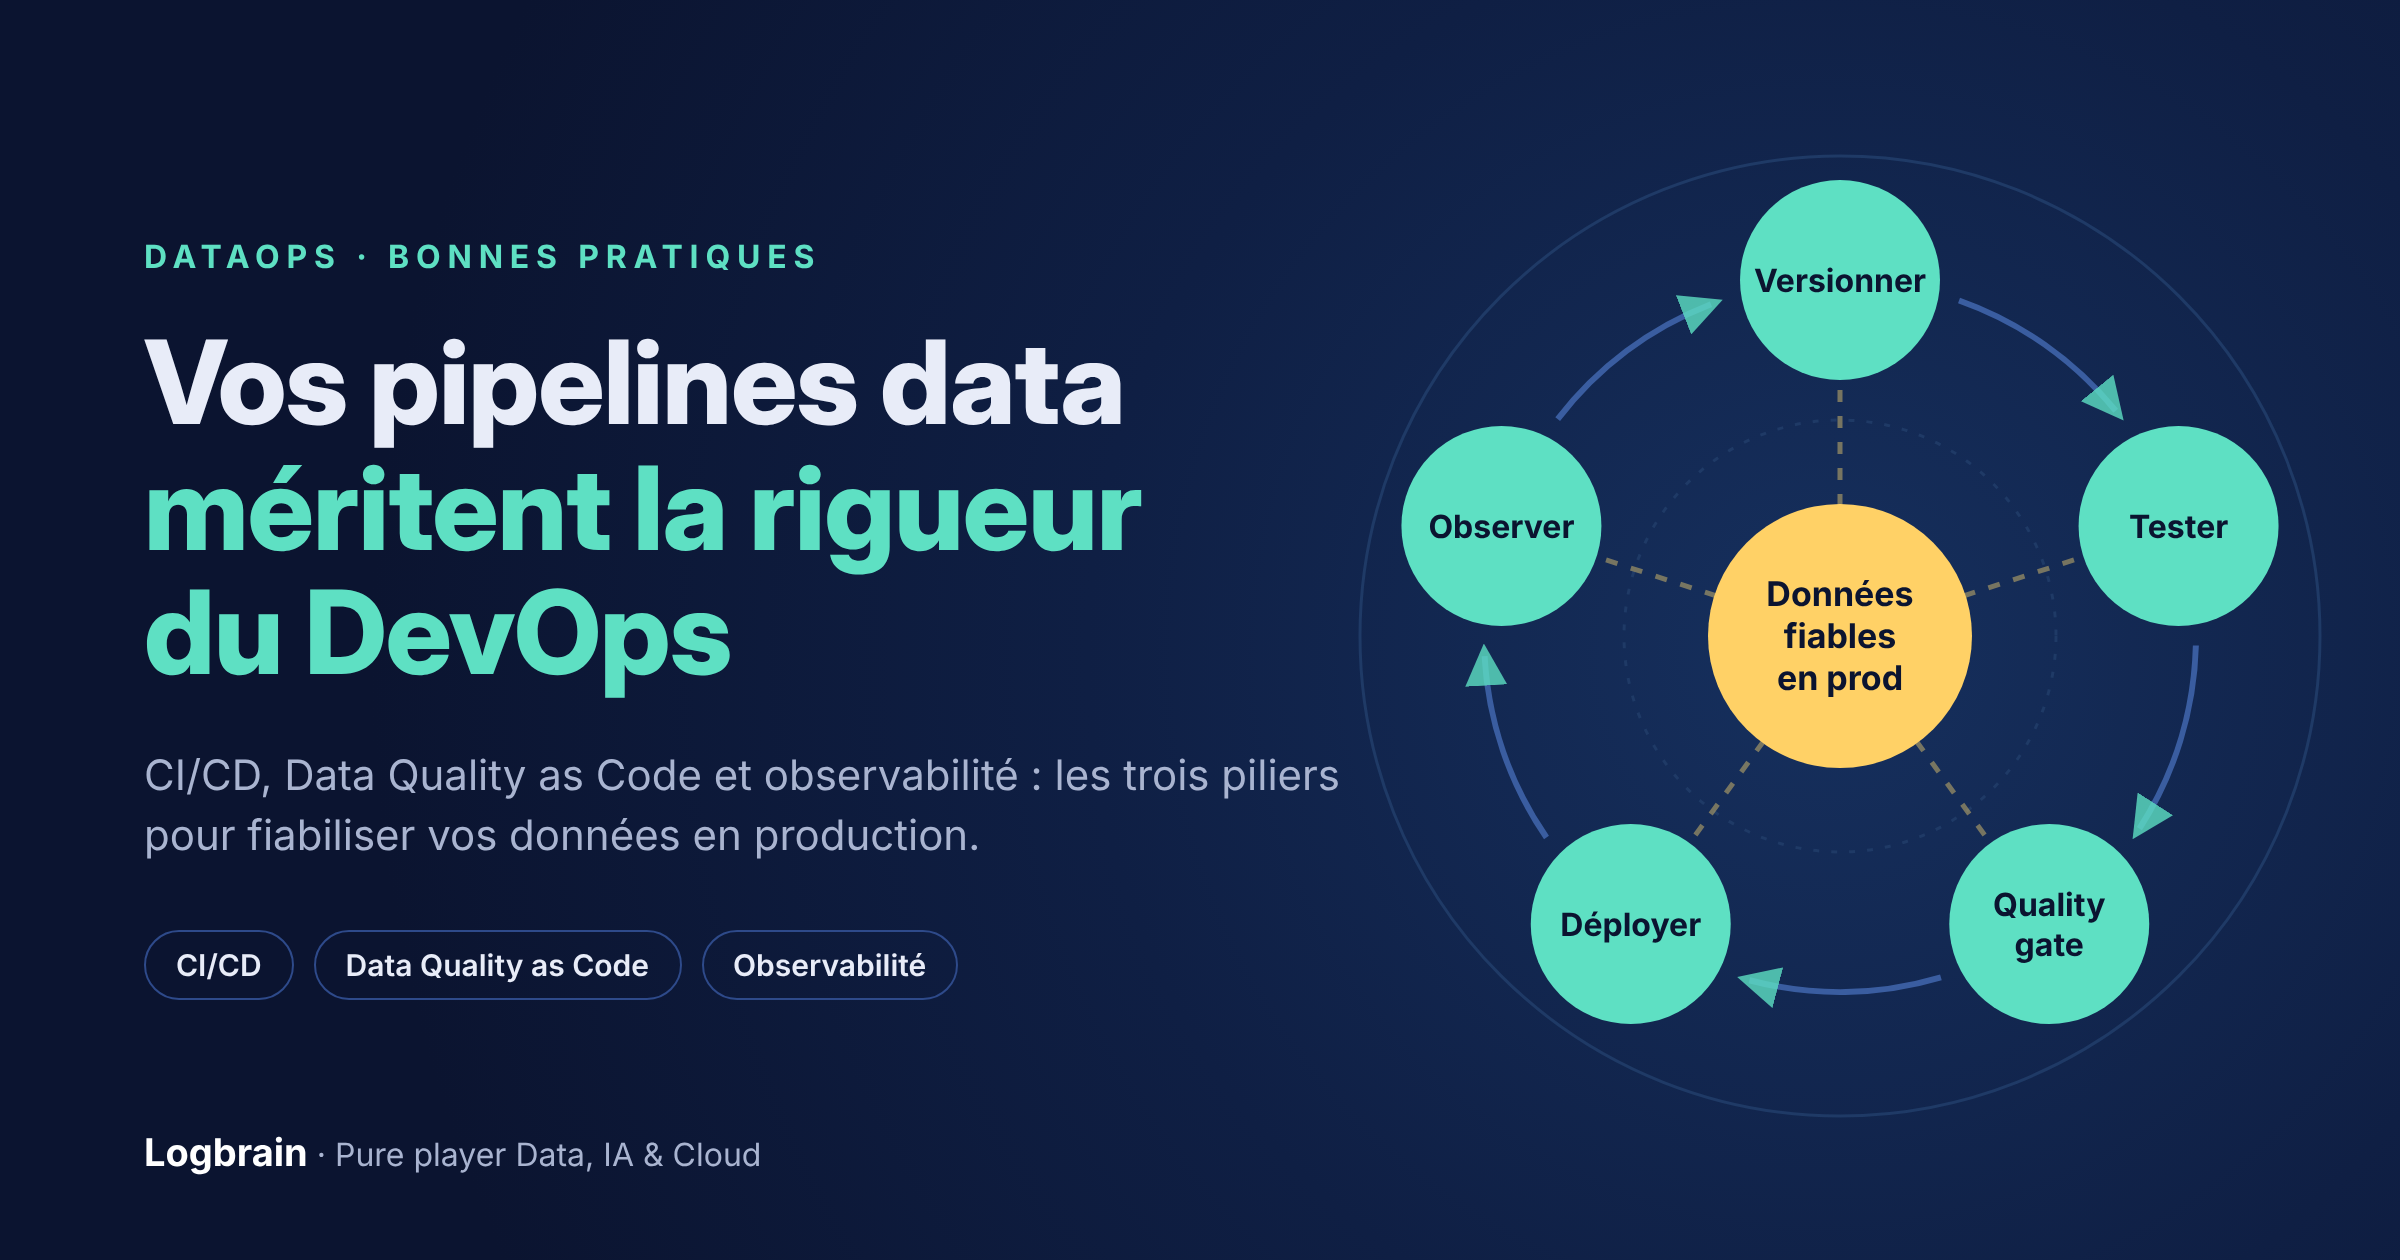
CI/CD, qualité as code, observabilité : trois piliers pour que vos pipelines data soient aussi fiables que vos applications.
La data engineering a longtemps fonctionné en dehors des pratiques DevOps modernes. Pendant que les équipes applicatives adoptaient l’intégration continue, les tests automatisés, l’infrastructure as code et le monitoring en production, les pipelines de données restaient trop souvent des scripts SQL déployés à la main, des jobs planifiés sans tests et des tableaux de bord dont on découvrait les erreurs… en comité de direction.
Ce temps est révolu. Les données alimentent désormais des décisions critiques, des produits clients, des obligations réglementaires et, de plus en plus, des modèles et des agents d’IA. Une donnée fausse n’est plus un simple désagrément : c’est un incident de production. Et un incident de production se prévient avec les mêmes disciplines que pour le logiciel.
C’est précisément l’objet du DataOps : appliquer à la chaîne de valeur data les principes qui ont fait leurs preuves côté DevOps (automatisation, tests, feedback rapide, responsabilité partagée) en les adaptant à une spécificité majeure : dans un pipeline data, ce n’est pas seulement le code qui peut casser, ce sont aussi les données.
Pourquoi la data a pris du retard
Le retard de la data engineering sur le DevOps n’est pas un manque de compétence, il a des causes structurelles.
- Des outils historiquement graphiques. Les ETL de première génération se configuraient par glisser-déposer, dans des outils propriétaires difficiles à versionner et impossibles à tester unitairement.
- Une double dépendance code et données. Un pipeline peut être parfaitement correct et produire un résultat faux parce que la source a changé de format, de volume ou de sens. Les tests classiques ne suffisent pas.
- Des environnements coûteux à dupliquer. Reproduire un entrepôt de plusieurs téraoctets pour tester une modification semblait hors de portée.
- Une culture du « ça tourne ». Tant que le job ne plante pas, on considère que tout va bien. La question « les données livrées sont-elles justes ? » reste sans réponse systématique.
Le cloud et la modern data stack ont levé la plupart de ces obstacles : transformations écrites en SQL ou en Python, donc versionnables ; entrepôts cloud capables de cloner des tables à moindre coût ; outils de test et d’observabilité conçus pour la donnée. Il n’y a plus d’excuse technique. Il reste à changer les pratiques.
Pilier 1 : CI/CD pour les pipelines data
Chaque pipeline ETL/ELT doit être versionné, testé et déployé de manière automatisée. C’est le socle, sans lequel les deux autres piliers n’ont pas de prise.
Versionner tout ce qui définit un pipeline
Le code de transformation, bien sûr, mais aussi la configuration d’orchestration, les définitions de schémas, les règles de qualité, les droits d’accès et l’infrastructure elle-même (Terraform, Pulumi ou équivalent). Si une modification ne passe pas par Git et par une revue de code, elle n’existe pas officiellement.
Tester avant de déployer
Une chaîne d’intégration continue pour la data vérifie à chaque pull request :
- que le code compile et respecte les conventions (linting SQL avec SQLFluff, par exemple) ;
- que les transformations produisent le résultat attendu sur des jeux de données de test (tests unitaires) ;
- que les données produites respectent les règles de qualité définies (tests de données, voir pilier 2) ;
- que la modification ne casse pas les modèles qui en dépendent en aval.
Des outils comme dbt facilitent considérablement cette approche grâce à leurs tests natifs et à leur graphe de dépendances. La fonctionnalité de state comparison permet notamment de ne reconstruire et tester que les modèles modifiés et leurs descendants (le fameux slim CI), ce qui rend la CI rapide et peu coûteuse :
# .github/workflows/dbt-ci.yml (extrait)
- name: Build & test des modèles modifiés
  run: |
    dbt deps
    dbt build --select state:modified+ --defer --state ./prod-artifacts --target ci
Déployer de manière automatisée et sûre
Le déploiement en production doit être une conséquence mécanique d’une fusion validée, pas une opération manuelle du vendredi soir. Plusieurs patterns permettent de limiter le risque :
- Des environnements isolés (dev, CI, recette, production), idéalement créés à la volée grâce au clonage zéro-copie des entrepôts cloud.
- Le pattern *Write-Audit-Publish* : les données sont écrites dans une zone intermédiaire, auditées par les tests de qualité, puis publiées uniquement si elles sont conformes.
- Le déploiement *blue/green* des tables ou des vues, pour basculer instantanément et revenir en arrière sans retraitement.
Notre recommandation : ne cherchez pas la perfection dès le départ. Un premier palier très rentable consiste à imposer Git et la revue de code sur toutes les transformations, puis à ajouter une CI qui exécute les tests dbt sur les modèles modifiés. Ce socle seul élimine une grande partie des régressions que nous rencontrons en audit.
Pilier 2 : Data Quality as Code
Tester le code ne suffit pas : il faut tester les données. Great Expectations, Soda ou les tests dbt permettent de définir des contrats de données explicites, écrits sous forme de code, versionnés et exécutés automatiquement.
Le principe est simple et non négociable : une pipeline qui livre des données de mauvaise qualité ne devrait pas passer en production. La qualité devient une quality gate, au même titre qu’un test unitaire qui échoue bloque une mise en production applicative.
À quoi ressemble un contrat de données
Avec dbt, les règles de qualité se déclarent au plus près du modèle, et le contrat de schéma peut être imposé à la compilation :
models:
  - name: fct_commandes
    config:
      contract:
        enforced: true
    columns:
      - name: commande_id
        data_type: varchar
        data_tests: [unique, not_null]
      - name: client_id
        data_type: varchar
        data_tests:
          - relationships:
              to: ref('dim_clients')
              field: client_id
      - name: statut
        data_type: varchar
        data_tests:
          - accepted_values:
              values: ['créée', 'payée', 'expédiée', 'annulée']
Avec Soda, les mêmes exigences s’expriment dans un langage déclaratif lisible par des profils non techniques, ce qui en fait un excellent support de dialogue avec les métiers :
checks for fct_commandes:
  - row_count > 0
  - missing_count(client_id) = 0
  - duplicate_count(commande_id) = 0
  - freshness(date_commande) < 1d
Great Expectations, de son côté, offre une grande richesse d'expectations et une documentation générée automatiquement, particulièrement utile dans les environnements Python et Spark.
Où placer les contrôles
Les contrôles les plus efficaces sont répartis à trois endroits du pipeline :
- À l’entrée, sur les sources : schéma, volumétrie, fraîcheur. C’est là qu’on détecte les changements non annoncés des systèmes amont.
- Pendant les transformations : unicité, intégrité référentielle, règles métier. C’est là qu’on détecte ses propres erreurs.
- À la publication, sur les données exposées aux consommateurs : le contrat promis est-il respecté ? C’est la dernière barrière avant l’utilisateur.
Notre recommandation : commencez par les données qui comptent. Identifiez les dix tables les plus consommées ou les plus critiques (reporting réglementaire, facturation, tableaux de bord de direction) et couvrez-les d’abord avec les tests de base : unicité, non-nullité, fraîcheur, volumétrie. Utilisez les niveaux de sévérité (avertissement ou blocage) pour distinguer ce qui doit arrêter la production de ce qui doit seulement alerter. Et surtout, faites valider les règles par les métiers : un contrat de données que personne n’a signé n’est qu’un test de plus.
Pilier 3 : l’observabilité data
Les tests vérifient ce que l’on sait anticiper. Mais en production, les incidents les plus coûteux sont ceux que l’on n’avait pas prévus : une source qui livre soudain moitié moins de lignes, une colonne dont la distribution dérive, un job qui finit avec trois heures de retard. Monter des pipelines en production sans observabilité, c’est naviguer à l’aveugle.
Ce qu’il faut observer
L’observabilité data repose généralement sur cinq signaux :
- La fraîcheur : les données sont-elles à jour par rapport à ce qui est attendu ?
- Le volume : le nombre de lignes reçues ou produites est-il cohérent avec l’historique ?
- Le schéma : des colonnes ont-elles été ajoutées, supprimées ou ont-elles changé de type ?
- La distribution : les valeurs restent-elles dans des plages plausibles (taux de nuls, moyennes, cardinalités) ?
- Le lignage : quelles tables et quels tableaux de bord en aval sont impactés par un incident ?
Plateformes du marché ou solution sur mesure
Des plateformes comme Monte Carlo ou Bigeye apportent une détection d’anomalies par apprentissage automatique sur ces signaux, sans avoir à écrire chaque règle à la main, ainsi qu’un lignage de bout en bout et une gestion des incidents intégrée. Elles permettent de détecter les incidents de manière proactive, avant que les consommateurs ne les signalent.
Pour les organisations qui disposent déjà d’une stack d’observabilité applicative, une solution custom basée sur OpenTelemetry est une alternative crédible : les pipelines émettent traces et métriques (durée des tâches, volumes traités, résultats des contrôles qualité) vers les mêmes outils que le reste du SI. Complétée par OpenLineage pour le lignage, cette approche offre une vision unifiée de la santé applicative et data, sans dépendance à un éditeur supplémentaire.
Le bon choix dépend de la taille du patrimoine, de la maturité de l’équipe et du coût d’un incident. Ce qui ne dépend de rien, c’est la nécessité d’en avoir une.
Organiser la réponse aux incidents
Détecter ne sert à rien si personne ne réagit. L’observabilité doit s’accompagner :
- de propriétaires identifiés pour chaque pipeline et chaque data product, qui reçoivent les alertes ;
- de niveaux de service explicites (par exemple : « la table des ventes est disponible chaque jour à 7 h avec un taux de complétude supérieur à 99,5 % ») ;
- d’un processus d’incident inspiré de l’exploitation applicative : qualification, communication aux consommateurs impactés, résolution, post-mortem.
Notre recommandation : traitez les incidents data comme des incidents de production, avec le même sérieux et les mêmes rituels. Mesurez le temps de détection et le temps de résolution. Et visez un objectif simple : que ce soit votre équipe data qui prévienne les métiers d’un incident, et jamais l’inverse.
Les pièges à éviter
Piège n°1 : acheter un outil pour acheter une culture
Aucun outil ne fait du DataOps à votre place. Une plateforme d’observabilité dont personne ne lit les alertes, ou une suite de tests que l’on désactive dès qu’elle bloque une livraison urgente, ne produit qu’un faux sentiment de sécurité. Le DataOps est d’abord une discipline d’équipe : revue de code systématique, refus de livrer sans tests, responsabilité claire sur chaque pipeline.
Piège n°2 : la fatigue d’alerte
À l’inverse, multiplier les tests et les moniteurs sans hiérarchie noie les équipes sous les notifications. Au bout de quelques semaines, plus personne ne les lit, et le véritable incident passe inaperçu. Mieux vaut vingt contrôles pertinents, reliés à des enjeux métier, que deux mille règles génériques.
Piège n°3 : réserver le DataOps aux ingénieurs
Les règles de qualité les plus utiles sont des règles métier : un montant ne peut pas être négatif, un client actif a forcément passé une commande dans les douze derniers mois. Si les métiers ne participent pas à leur définition, les contrôles resteront techniques et passeront à côté des erreurs qui comptent vraiment.
DataOps et IA : une condition de l’industrialisation
En 2026, la question de la fiabilité des données a pris une dimension nouvelle. Les projets d’IA générative et d’IA agentique consomment des données en continu : bases documentaires pour le RAG, données transactionnelles interrogées par des agents, jeux d’entraînement et d’évaluation des modèles.
Or une IA alimentée par des données fausses, périmées ou incomplètes ne signale pas l’erreur : elle produit une réponse fausse avec aplomb. Les trois piliers du DataOps s’appliquent donc directement aux pipelines qui alimentent l’IA. Versionner et tester les chaînes d’ingestion documentaire, contrôler la fraîcheur et la complétude des index vectoriels, observer la dérive des données en entrée des modèles : ce sont les mêmes pratiques, appliquées à de nouveaux consommateurs.
Les organisations qui maîtrisent déjà le DataOps passent beaucoup plus vite du prototype d’IA à la production. Les autres découvrent, au moment du passage à l’échelle, que leur problème n’est pas le modèle, mais la donnée.
Où en êtes-vous ?
Quelques questions pour évaluer rapidement votre maturité DataOps :
- Toutes vos transformations de données sont-elles versionnées dans Git et soumises à une revue de code ?
- Une modification peut-elle être déployée en production sans intervention manuelle, et annulée aussi facilement ?
- Vos tables critiques sont-elles couvertes par des tests de qualité qui bloquent la publication en cas d’échec ?
- Disposez-vous de contrats de données validés avec les producteurs et les consommateurs ?
- Savez-vous combien de temps il faut pour détecter un incident data, et qui en est informé en premier ?
- Pouvez-vous dire, en quelques minutes, quels tableaux de bord sont impactés par une source défaillante ?
Si plusieurs réponses sont négatives, la bonne nouvelle est que les premiers gains sont rapides : Git, une CI avec les tests dbt sur les modèles critiques et des alertes de fraîcheur et de volume suffisent souvent à transformer la fiabilité perçue de la plateforme data en quelques mois.
Conclusion
Le DataOps n’est pas une mode ni un nouvel outil à ajouter à la stack. C’est la reconnaissance d’une évidence : les données sont un produit de production, et elles méritent la même rigueur d’ingénierie que le logiciel.
CI/CD pour livrer vite et sans régression, Data Quality as Code pour ne jamais publier de données fausses, observabilité pour détecter les incidents avant les utilisateurs : ces trois piliers se renforcent mutuellement. Ensemble, ils transforment une équipe data qui éteint des incendies en une équipe qui livre de la valeur en confiance.
La question n’est plus « faut-il industrialiser nos pipelines data ? », mais « combien nous coûte, chaque mois, le fait de ne pas l’avoir encore fait ? »
Vous souhaitez industrialiser vos pipelines data ou évaluer la maturité DataOps de votre plateforme ? Les experts Logbrain, pure player data, IA et cloud, vous accompagnent de l’audit à la mise en place de vos chaînes CI/CD, de vos contrats de données et de votre observabilité. Parlons de votre situation